1.回顾MySQL的执行过程
MySQL内部服务组件可以分为server层和存储引擎层,其中跨存储引擎的功能都在server实现,比如触发器、视图等,而存储引擎执行实际的IO操作,数据的存储和提取。
数据库里面,长连接是指连接成功后,如果客户端持续有请求,那么就一直使用同一个连接,短连接则是指每次执行完很少的几次查询就断开连接,下次查询再建立一个
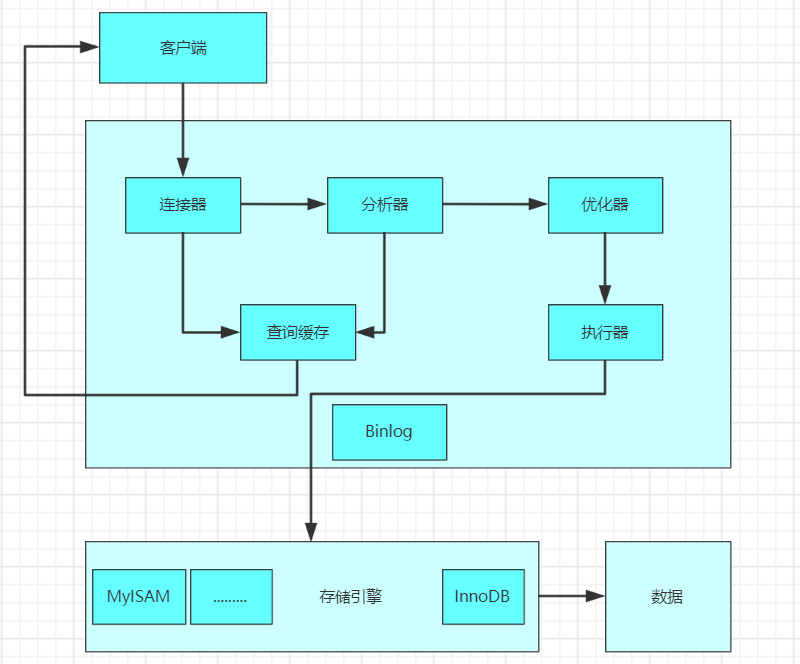
- 在
mysql8.0以前,执行查询的sql会先经过缓存,查询缓存是否命中,如果缓存命中,那么就会直接返回结果,否则就会走查询流程 - 查询流程会先经过
分析器,分析器要完成两个事情,第一个事情是做词法分析,第二个事情叫做语法分析,解析器会对语法进行验证和解析,并生成一颗对应的抽象语法树,。例如,验证是否使用了错误的关键字,或者关键字的使用是否正确 - 预处理是根据一些MySQL规则检查语法树是否合理,比如检查表和列是否存在,还会解析名字和别名,然后预处理器会验证权限;
- 优化器生成执行计划,根据执行计划查询执行引擎,调用API接口调用存储引擎来查询数据;
- 最终将数据收集,返回给客户端程序。
2.SQL语句性能优化常用策略
1.为 WHERE 及 ORDER BY 涉及的列上建立索引
对查询进行优化,应尽量避免全表扫描,首先应考虑在 WHERE 及 ORDER BY 涉及的列上建立索引。
2.where中使用默认值代替null
应尽量避免在 WHERE 子句中对字段进行 NULL 值判断,创建表时 NULL 是默认值,但大多数时候应该使用 NOT NULL,或者使用一个特殊的值,如 0,-1 作为默认值。
原因:如果是用null或者is not null的话可能有时候让索引失效,成本比走索引更高的话就会全表扫描。而换成默认值就更可能走索引
3.慎用 != 或 <> 操作符
MySQL 只有对以下操作符才使用索引:<,<=,=,>,>=,BETWEEN,IN,以及某些时候的 LIKE。
所以:应尽量避免在 WHERE 子句中使用 != 或 <> 操作符, 会导致全表扫描。
4.慎用 OR 来连接条件
使用or可能会使索引失效,从而全表扫描;
应尽量避免在 WHERE 子句中使用 OR 来连接条件,否则将导致引擎放弃使用索引而进行全表扫描,
可以使用 UNION 合并查询:
select id from t where num=10
union all
select id from t where num=20;
一个关键的问题是否用到索引。他们的速度只同是否使用索引有关,如果查询需要用到联合索引,用 UNION all 执行的效率更高。多个 OR 的字句没有用到索引,改写成 UNION 的形式再试图与索引匹配。
5.慎用 IN 和 NOT IN
IN 和 NOT IN 要慎用,否则会导致全表扫描。对于连续的数值,能用 BETWEEN 就不要用 IN:
select id from t where num between 1 and 3;6.慎用 左模糊like ‘%…’
模糊查询,程序员最喜欢的就是使用like,like很可能让索引失效。
比如:
select id from t where name like‘%abc%’
select id from t where name like‘%abc’
上面两种情况都不会走索引,只有 like ‘abc%’ 才会走索引。
所以:
- 首先尽量避免模糊查询,如果必须使用,不采用全模糊查询,也应尽量采用右模糊查询, 即like ‘…%’,是会使用索引的;
- 左模糊like ‘%…’无法直接使用索引,但可以利用reverse + function index的形式,变化成 like ‘…%’;
- 全模糊查询是无法优化的,一定要使用的话建议使用搜索引擎,比如 ElasticSearch。
- 如果一定要用左模糊like ‘%…’检索, 一般建议 ElasticSearch+Hbase架构。
7.WHERE条件使用参数会导致全表扫描
如下面语句将进行全表扫描:
select id from t where num = @num因为SQL只有在运行时才会解析局部变量,但优化程序不能将访问计划的选择推迟到运行时;
它必须在编译时进行选择。然而,如果在编译时建立访问计划,变量的值还是未知的,因而无法作为索引选择的输入项。
所以, 可以改为强制查询使用索引:
select id from t with(index(索引名)) where num=@num8.用 EXISTS 代替 IN 是一个好的选择
很多时候用exists 代替in 是一个好的选择:
select num from a where num in(select num from b) 用下面的语句替换:
select num from a where exists(select 1 from b where num=a.num)9.索引并不是越多越好
索引固然可以提高相应的 SELECT 的效率,但同时也降低了 INSERT 及 UPDATE 的效率。因为 INSERT 或 UPDATE 时有可能会重建索引,所以怎样建索引需要慎重考虑,视具体情况而定。
一个表的索引数最好不要超过 6 个,若太多则应考虑一些不常使用到的列上建的索引是否有必要。
10.尽量使用数字型字段
- 因为引擎在处理查询和连接时会逐个比较字符串中每一个字符;
- 而对于数字型而言只需要比较一次就够了;
- 字符会降低查询和连接的性能,并会增加存储开销;
所以:尽量使用数字型字段,若只含数值信息的字段尽量不要设计为字符型,这会降低查询和连接的性能,并会增加存储开销。
11.尽可能地使用 varchar, nvarchar 代替 char, nchar
- varchar变长字段按数据内容实际长度存储,存储空间小,可以节省存储空间;
- char按声明大小存储,不足补空格;
- 其次对于查询来说,在一个相对较小的字段内搜索,效率更高;
因为首先变长字段存储空间小,可以节省存储空间,其次对于查询来说,在一个相对较小的字段内搜索效率显然要高些。
12.查询SQL尽量不要使用select *,而是具体字段
最好不要使用返回所有:select * from t ,用具体的字段列表代替 “*”,不要返回用不到的任何字段。
select *的弊端:
- 增加很多不必要的消耗,比如CPU、IO、内存、网络带宽;
- 增加了使用覆盖索引的可能性;
- 增加了回表的可能性;
13.将需要查询的结果预先计算好
将需要查询的结果预先计算好放在表中,查询的时候再select,而不是查询的时候进行计算。
14.IN后出现最频繁的值放在最前面
如果一定用IN,那么:
在IN后面值的列表中,将出现最频繁的值放在最前面,出现得最少的放在最后面,减少判断的次数。
15.尽量使用 EXISTS 代替 select count(1) 来判断是否存在记录
count 函数只有在统计表中所有行数时使用,而且 count(1) 比 count(*) 更有效率。
16.用批量插入或批量更新
当有一批处理的插入或更新时,用批量插入或批量更新,绝不会一条条记录的去更新。
1.多条插入
INSERT INTO user (id,username) VALUES(1,'xx');
INSERT INTO user (id,username) VALUES(2,'yy');
2.批量提交
INSERT INTO user (id,username) VALUES(1,'xx'),(2,'yy'); 默认新增SQL有事务控制,导致每条都需要事务开启和事务提交,而批量处理是一次事务开启和提交,效率提升明显,达到一定量级,效果显著,平时看不出来。
17.将不需要的记录在 GROUP BY 之前过滤掉
提高 GROUP BY 语句的效率,可以通过将不需要的记录在 GROUP BY 之前过滤掉。
下面两个查询返回相同结果,但第二个明显就快了许多。
# 低效
SELECT JOB, AVG(SAL)
FROM EMP
GROUP BY JOB
HAVING JOB = 'PRESIDENT'
OR JOB = 'MANAGER'
#高效
SELECT JOB, AVG(SAL)
FROM EMP WHERE JOB = 'PRESIDENT'
OR JOB = 'MANAGER'
GROUP BY JOB18.避免死锁
在你的存储过程和触发器中访问同一个表时总是以相同的顺序;事务应尽可能地缩短,在一个事务中应尽可能减少涉及到的数据量;永远不要在事务中等待用户输入。
19.索引创建规则
- 数据量超过 300 的表应该有索引;
- 经常与其他表进行连接的表,在连接字段上应该建立索引;
- 经常出现在 WHERE 子句中的字段,特别是大表的字段,应该建立索引;
- 索引应该建在选择性高的字段上;
- 索引应该建在小字段上,对于大的文本字段甚至超长字段,不要建索引;
- 复合索引的建立需要进行仔细分析,尽量考虑用单字段索引代替;
- 正确选择复合索引中的主列字段,一般是选择性较好的字段;
- 复合索引的几个字段是否经常同时以 AND 方式出现在 WHERE 子句中?单字段查询是否极少甚至没有?如果是,则可以建立复合索引;否则考虑单字段索引;
- 如果复合索引中包含的字段经常单独出现在 WHERE 子句中,则分解为多个单字段索引;
- 如果复合索引所包含的字段超过 3 个,那么仔细考虑其必要性,考虑减少复合的字段;
- 如果既有单字段索引,又有这几个字段上的复合索引,一般可以删除复合索引;
- 频繁进行数据操作的表,不要建立太多的索引;
- 删除无用的索引,避免对执行计划造成负面影响;
- 表上建立的每个索引都会增加存储开销,索引对于插入、删除、更新操作也会增加处理上的开销。另外,过多的复合索引,在有单字段索引的情况下,一般都是没有存在价值的;相反,还会降低数据增加删除时的性能,特别是对频繁更新的表来说,负面影响更大;
- 尽量不要对数据库中某个含有大量重复的值的字段建立索引。
20.在写 SQL 语句时,应尽量减少空格的使用
查询缓冲并不自动处理空格,因此,在写 SQL 语句时,应尽量减少空格的使用,尤其是在 SQL 首和尾的空格(因为查询缓冲并不自动截取首尾空格)。
21.每张表都设置一个 ID 做为其主键
我们应该为数据库里的每张表都设置一个 ID 作为其主键,而且最好的是一个 INT 型的(推荐使用 UNSIGNED),并设置上自动增加的 AUTO_INCREMENT 标志。
22.使用explain分析你SQL执行计划
| 列名 | 描述 |
|---|---|
| type | 针对单表的访问方法 |
| possible_keys | 可能用到的索引 |
| key | 实际使用的索引 |
| key_len | 实际使用的索引长度 |
| ref | 当使用索引列等值查询时,与索引列等值匹配的对象信息 |
| rows | 预估的需要读取的记录条数 |
| filtered | 针对rows,经过搜索条件过滤后剩余记录条数百分百 |
| Extra | 一些额外信息 |
(1)type常用值
system:表仅有一条记录,基本用不到;
const:在根据主键或者唯一二级索引列进行等值匹配查询时会触发
eq_ref:执行连接查询时,被驱动的表是通过主键或者不允许存储NULL值的唯一二级索引序列等值匹配的方式进行访问的。这可能是最好的联接类型,除了const类型;
select * from s1 inner join s2 on s1.id = s2.id;ref:当通过普通的二级索引列与常量进行等值匹配的方式来查询某个表时,对该表的访问方式就是ref。
range:如果使用索引获取某些单点扫描区间的记录,那么就可能使用到range访问方法,或者用于获取某个或者某些范围扫描区间的记录的查询,例如:
select * from s1 where key1 in ('a','b','c');

select * from s1 where key1 > 'a' and key1 < 'c';
index:当可以使用索引覆盖,但需要扫描全部的索引记录时,该表的访问方法就是index。例如:
select key_part1 from s1 where key_part2 = 'a';上述查询中(key_part1,key_part2)是联合索引,查询的只有一个列,搜索的也只有一个列,但是只能扫描索引的全部记录
all:全表扫描
性能排名:system > const > eq_ref > ref > range > index > all。实际sql优化中,最后达到ref或range级别。
(2)Extra常用关键字
- Using index:只从索引树中获取信息,而不需要回表查询;
- Using where:WHERE子句用于限制哪一个行匹配下一个表或发送到客户。除非你专门从表中索取或检查所有行,如果Extra值不Using where并且表联接类型为ALL或index,查询可能会有一些错误。需要回表查询;
- Using temporary:mysql常建一个临时表来容纳结果,典型情况如查询包含可以按不同情况列出列的GROUP BY和ORDER BY子句时。
23.当只要一行数据时使用 LIMIT 1
当你查询表的有些时候,你已经知道结果只会有一条结果,但因为你可能需要去fetch游标,或是你也许会去检查返回的记录数。
在这种情况下,加上 LIMIT 1 可以增加性能。
这样一来,MySQL 数据库引擎会在找到一条数据后停止搜索,而不是继续往后查找下一条符合记录的数据。
24.将大的DELETE,UPDATE、INSERT 查询变成多个小查询
能写一个几十行、几百行的SQL语句是不是显得逼格很高?然而,为了达到更好的性能以及更好的数据控制,你可以将他们变成多个小查询。
25.合理分表,尽量控制单表数据量的大小,建议控制在500万以内
500万并不是MySQL数据库的限制,过大会造成修改表结构,备份,恢复都会有很大的问题。
可以用历史数据归档(应用于日志数据),分库分表(应用于业务数据)等手段来控制数据量大小。
26.无条件删除表中数据时,用truncate代替delete
delete操作是将表中所有记录一条一条删除直到删除完;truncate操作则是保留了表的结构,重新创建了这个表。因此truncate操作的效率更高
delete操作删除表中记录后,再次向表中添加新记录时,对于设置有自增约束字段的值会从删除前表中该字段的最大值加1开始自增;truncate操作则会重新从1开始自增。