1.在MySQL中有哪些锁?
按粒度分:
- 表级锁
- 全局锁
- 行级锁
按操作分:
- 共享锁
- 排他锁
按使用方式分类:
- 乐观锁
- 悲观锁
InnoDB中常用的行级锁有(下文默认的存储引擎为InnoDB):
- Record Lock:又细分为共享锁(Shared Lock,简称S锁),在事务要读取一条记录时,首先需要获取该记录的S锁。独占锁(Exclusive Lock,简称X锁),在事务要改动一条记录时,首先需要获取该记录的X锁。总之,它的作用仅仅是把一条记录锁上。
- Gap Lock:又称为间隙锁,锁定一个范围, 但是不包含记录本身。在RR的隔离级别下可能会出现幻读的现象。解决的方案有两种:使用MVCC方案解决;使用加锁方案解决。
- Next-Key Lock:锁定一个范围包括记录本身。Record Lock + Gap Lock = Next-Key Lock
常用的表级锁有:
- 意向共享锁(Intention Shared Lock):简称IS锁,当事务准备在某条记录上加S锁时,需要先在表级别加IS锁
- 意向独占锁(Intention Exclusive Lock):简称IX锁,当事务准备在某条记录上加X锁时,需要先在表级别加IX锁
- AUTO-INC锁:为某个列添加AUTO_INCREMENT属性后,在插入记录时,就会添加一个AUTO-INC锁,其他事务的插入语句就会被阻塞。
- 元数据锁(Metadata Lock,MDL)
IS锁,IX锁的提出仅仅是为了在之后加表级别的X锁和S锁时可以快速判断表中的记录是否被上锁,避免用遍历的方式来查看表中有没有上锁的记录。
其实表级别的X锁和S锁相当的“鸡肋”,它们并不会提供什么额外保护,只是会降低并发能力而已,只会在一些特殊的情况用到(比如系统崩溃恢复时)。
X锁与任何锁不兼容,IX锁与S/X锁不兼容。
2.什么时候要用全局锁,怎么用?
锁的基本应用场景是在多线程并发操作下使用的,全局锁也是如此
Mysql需要定期做一个数据库的备份,由于备份的过程涉及到大量的I/O,因此在这种情况下,如果不对用户的访问加以限制,那么就很有可能产生并发的错误
我们假设一个网购的例子,A从商店中购买了C商品,消耗了D元,那么这个过程可以分为对两张表的操作
- 1.用户表中A的余额要减D
- 2.商店中C商品的库存要减去1
假设现在数据库备份线程正在执行,假设没有加锁,允许用户线程并发执行。1在备份线程备份数据库之前执行了,2在备份线程数据库之后执行了。这样的话就产生了数据的不一致的问题,最终导致错误。当1和2的顺序调换的时候,会导致更加严重的问题,用户相当于买了一件商品而且余额没减!这是严重的生产事故。
要使用全局锁,那么可以使用内置的悲观锁,使用的指令如下:
flush tables with read lock执行完了之后,整个数据库的状态就处于只读的状态了,当执行以下几种指令的时候,就会导致阻塞
- 对数据库表的结构的DDL语句:比如说
alter table、drop table等语句 - 对数据库数据的CRUD的DML语句,比如说
insert、update、delete等语句
在加锁完成业务后,就可以执行解锁:
unlock tables当会话断开了,全局锁就会被自动释放
3.什么是锁定读,怎么使用锁定读?
在InnoDB下,普通的select语句根据事务的隔离级别可能会读取到历史版本数据,读-写操作并不冲突,性能更高;如果采用加锁方式,读-写操作彼此需要并发执行,从而影响性能。一般情况下我们更愿意采用MVCC来解决读-写并发问题,但是在某些特殊业务场景中,我们必须采用加锁的方式读取最新数据,那也是没办法的事。
读取记录时加S锁:
select ... lock in share mode;读取记录时加X锁:
select ... for update4.锁的内存结构
对一条记录加锁的本质就是在内存中创建一个锁结构与之关联,隐式锁除外。
为了节约内存空间,在对不同记录加锁时,如果符合下面这些条件,这些记录的锁就可以放到一个锁结构中:
- 在同一个事务事务中进行加锁操作;
- 被加锁的记录在同一个页面中;
- 加锁的类型是一样的
- 等待状态是一样的
具体的锁结构为:
- 事务信息:锁对应的事务信息,一个锁属于一个事务
- 索引信息:对于行级锁,需要记录加锁的记录属于哪个索引
- 表锁和行锁信息:表锁记录着锁定的表,行锁记录了 Space ID 所在表空间、Page Number 所在的页号、n_bits 使用了多少比特
- type_mode:一个 32 比特的数,被分成 lock_mode、lock_type、rec_lock_type 三个部分
- lock_mode:锁模式,记录是共享锁、排他锁、意向锁之类
- lock_type:代表表级锁还是行级锁
- rec_lock_type:代表行锁的具体类型和 is_waiting 属性,is_waiting = true 时表示当前事务尚未获取到锁,处于等待状态。事务获取锁后的锁结构是 is_waiting 为 false,释放锁时会检查是否与当前记录关联的锁结构,如果有就唤醒对应事务的线程
5.什么是隐式锁
在内存总生成锁结构并维护它们并不是一件零成本的事,因此提出了隐式锁。比如一般情况执行INSERT语句是不需要在内存中生成锁结构的(当然,如果即将插入的间隙已经被其他事务加上了gap锁,那么本次INSERT操作会阻塞,并且当前事务会在该间隙上加上一个插入意向锁),单纯依靠隐式锁(其实就是记录的trx_id属性)保护插入的记录。
- 聚簇索引:索引记录有 trx_id 隐藏列,表示最后改动该记录的事务 id,插入数据后事务 id 就是当前事务。其他事务想获取该记录的锁时会判断当前记录的事务 id 是否是活跃的,如果不是就可以正常加锁;如果是就创建一个 X 的锁结构,该锁的 is_waiting 是 false,为自己的事务创建一个锁结构,is_waiting 是 true(类似 Java 中的锁升级)
- 二级索引:获取数据页 Page Header 中的 PAGE_MAX_TRX_ID 属性,代表修改当前页面的最大的事务 ID,如果小于当前活跃的最小事务 id,就证明插入该数据的事务已经提交,否则就需要获取到主键值进行回表操作
隐式锁起到了延迟生成锁的效果,如果其他事务与隐式锁没有冲突,就可以避免锁结构的生成,节省了内存资源
INSERT 在两种情况下会生成锁结构:
重复键:在插入主键或唯一二级索引时遇到重复的键值会报错,在报错前需要对对应的聚簇索引进行加锁
- 隔离级别 <= Read Uncommitted,加 S 型 Record Lock
- 隔离级别 >= Repeatable Read,加 S 型 next_key 锁
外键检查:如果待插入的记录在父表中可以找到,会对父表的记录加 S 型 Record Lock。如果待插入的记录在父表中找不到
- 隔离级别 <= Read Committed,不加锁
- 隔离级别 >= Repeatable Read,加间隙锁
6.怎么优化锁?
InnoDB 存储引擎实现了行级锁定,虽然在锁定机制的实现方面带来了性能损耗可能比表锁会更高,但是在整体并发处理能力方面要远远优于 MyISAM 的表锁,当系统并发量较高的时候,InnoDB 的整体性能远远好于 MyISAM
但是使用不当可能会让 InnoDB 的整体性能表现不仅不能比 MyISAM 高,甚至可能会更差
优化建议:
- 尽可能让所有数据检索都能通过索引来完成,避免无索引行锁升级为表锁
- 合理设计索引,尽量缩小锁的范围
- 尽可能减少索引条件及索引范围,避免间隙锁
- 尽量控制事务大小,减少锁定资源量和时间长度
- 尽可使用低级别事务隔离(需要业务层面满足需求)
7.什么是锁升级?
索引失效造成行锁升级为表锁,不通过索引检索数据,全局扫描的过程中 InnoDB 会将对表中的所有记录加锁,实际效果和表锁一样,实际开发过程应避免出现索引失效的状况
查看当前表的索引:
SHOW INDEX FROM test_innodb_lock;关闭自动提交功能:
SET AUTOCOMMIT=0; -- C1、C2执行更新语句:
UPDATE test_innodb_lock SET sex='2' WHERE name=10;	-- C1
UPDATE test_innodb_lock SET sex='2' WHERE id=3;		-- C2
索引失效:执行更新时 name 字段为 varchar 类型,造成索引失效,最终行锁变为表锁
8.什么是死锁,如何避免?
不同事务由于互相持有对方需要的锁而导致事务都无法继续执行的情况称为死锁。
例如:事务T1需要对记录A和B进行修改,事务T2也需要对记录A和B进行修改,当T1获取了记录A的X锁时,需要获取B的X锁,此时T2获取了B的X锁,准备去获取A的X锁。这个时候就发生了死锁。
解决策略:
超时回滚。当一个事务等待时间超过设置的阈值时,就会进行回滚,另一个事务就能正常执行。,超时时间可以通过参数 innodb_lock_wait_timeout 来设置,默认 50 秒,但是时间的设置不好控制。如果一个事务没有死锁,就是因为业务执行比较慢,但是还没有执行就超时然后回滚了,所以一般不采取该方式。
死锁检测。采用等待图的方式来进行死锁检测,发现死锁后主动回滚死锁链条中较小的一个事务,让其他事务得以继续执行。这是一种更为主动的方式。将参数
innodb_deadlock_detect设置为 on,表示开启该功能(事务较小的意思就是事务执行过程中插入、删除、更新的记录条数)死锁检测并不是每个语句都要检测,只有在加锁访问的行上已经有锁时,当前事务被阻塞了才会检测,也是从当前事务开始进行检测
通过执行
SHOW ENGINE INNODB STATUS可以查看最近发生的一次死循环,全局系统变量innodb_print_all_deadlocks设置为 on,就可以将每个死锁信息都记录在 MySQL 错误日志中死锁一般是行级锁,当表锁发生死锁时,会在事务中访问其他表时直接报错,破坏了持有并等待的死锁条件
等待图:图中出现回路,说明出现了死锁的情况。
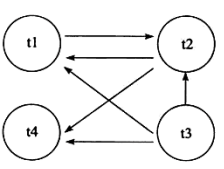
6.什么是乐观锁?
悲观锁:在整个数据处理过程中,将数据处于锁定状态,为了保证事务的隔离性,就需要一致性锁定读。读取数据时给加锁,其它事务无法修改这些数据,修改删除数据时也加锁,其它事务同样无法读取这些数据
悲观锁和乐观锁使用前提:
- 对于读的操作远多于写的操作的时候,一个更新操作加锁会阻塞所有的读取操作,降低了吞吐量,最后需要释放锁,锁是需要一些开销的,这时候可以选择乐观锁
- 如果是读写比例差距不是非常大或者系统没有响应不及时,吞吐量瓶颈的问题,那就不要去使用乐观锁,它增加了复杂度,也带来了业务额外的风险,这时候可以选择悲观锁
乐观锁的实现方式:就是 CAS,比较并交换
版本号
给数据表中添加一个 version 列,每次更新后都将这个列的值加 1
读取数据时,将版本号读取出来,在执行更新的时候,比较版本号
如果相同则执行更新,如果不相同,说明此条数据已经发生了变化
用户自行根据这个通知来决定怎么处理,比如重新开始一遍,或者放弃本次更新
-- 创建city表
CREATE TABLE city(
	id INT PRIMARY KEY AUTO_INCREMENT,  -- 城市id
	NAME VARCHAR(20),                   -- 城市名称
	VERSION INT                         -- 版本号
);

-- 添加数据
INSERT INTO city VALUES (NULL,'北京',1),(NULL,'上海',1),(NULL,'广州',1),(NULL,'深圳',1);

-- 修改北京为北京市
-- 1.查询北京的version
SELECT VERSION FROM city WHERE NAME='北京';
-- 2.修改北京为北京市,版本号+1。并对比版本号
UPDATE city SET NAME='北京市',VERSION=VERSION+1 WHERE NAME='北京' AND VERSION=1;
时间戳
- 和版本号方式基本一样,给数据表中添加一个列,名称无所谓,数据类型需要是 timestamp
- 每次更新后都将最新时间插入到此列
- 读取数据时,将时间读取出来,在执行更新的时候,比较时间
- 如果相同则执行更新,如果不相同,说明此条数据已经发生了变化
乐观锁的异常情况:如果 version 被其他事务抢先更新,则在当前事务中更新失败,trx_id 没有变成当前事务的 ID,当前事务再次查询还是旧值,就会出现值没变但是更新不了的现象(anomaly)
解决方案:每次 CAS 更新不管成功失败,就结束当前事务;如果失败则重新起一个事务进行查询更新
7.AUTO-INC锁是什么?有什么用?
通常来说,我们会将表的主键设置为自增的,而自增主键的id分配的这个过程并不是原子性的,因此可能会导致多个线程同时插入数据的时候,导致自增主键相同的问题。
那么在这样的情况下,就需要给分配自增主键的过程的加一个锁,让每个线程都能分配到唯一的ID
目前来说,自增主键分配过程的上锁策略有三种,可以通过调整innodb_autoinc_lock_mode这个变量进行实现
第一种,在innodb_autoinc_lock_mode = 0 的时候,采取的是最安全的方式,也就是只有当语句执行完毕的时候,才会释放这个锁,然后其他想要insert的线程才能够获取到自增的id,会造成线程的阻塞
第二种,在innodb_autoinc_lock_mode = 1的时候,采取了一种折中的方案,当能够提前知道需要多少个ID的时候,就会使用一种轻量级锁的机制,这种机制的工作原理就是对字段进行上锁,当有人在申请ID的时候,其他事务不能够插队,但是当不知道当前需要多少个ID的时候,就需要加这个表级锁了
第三种,在innodb_autoinc_lock_mode = 2的时候,一律采取轻量级锁的机制,也就是只对字段加锁,而不对整个表进行加锁,在这种情况会产生并发问题,这也就是为什么=1时在是不知道插入语句条数的时候要采用表锁的原因
考虑一个主从复制的场景
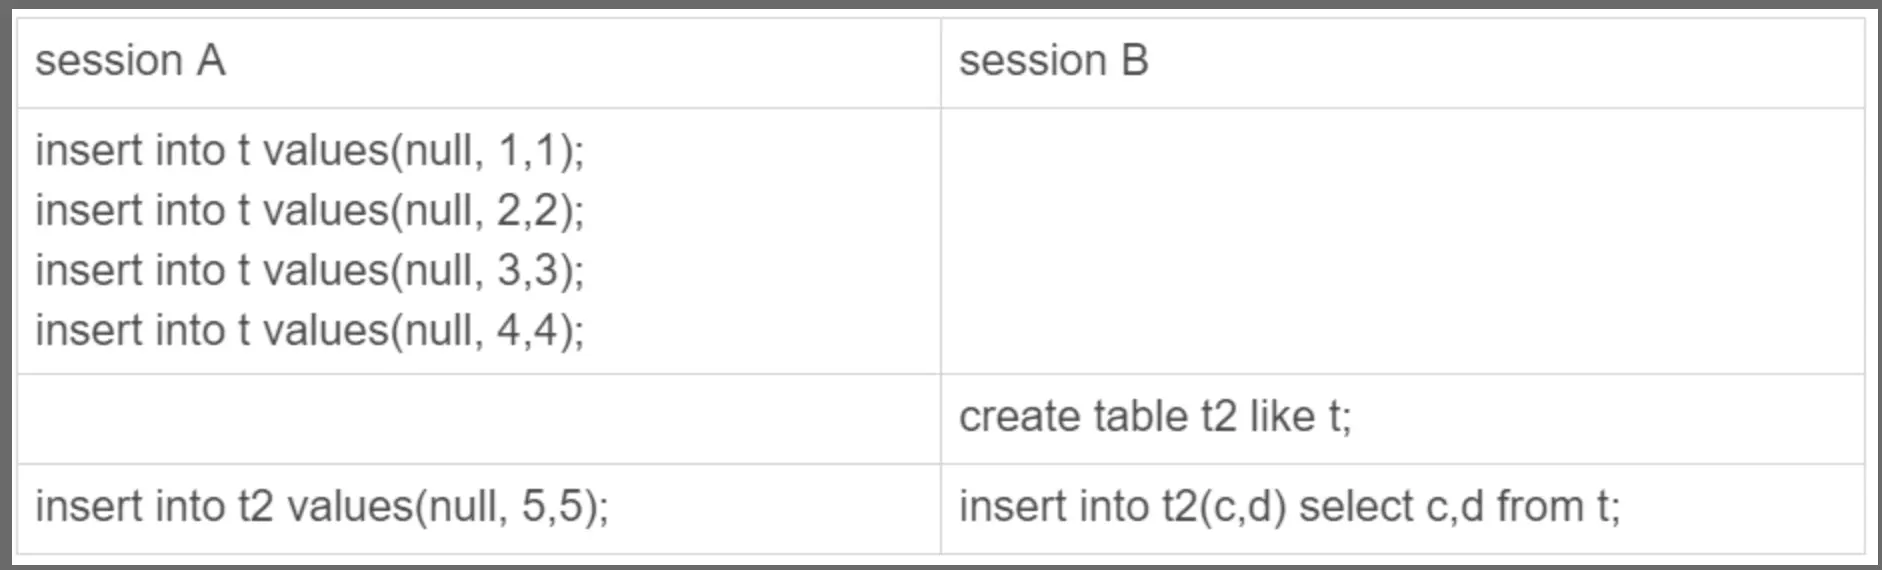
在这个情况下,有两个线程并发执行,具体的操作可以描述如下:
- sessionB先插入了两条记录,内容是
(1,1,1)、(2,2,2) - 并发执行,A插入了
(3,5,5) - 然后sessionB插入了
(4,3,3),(5,4,4)
于是在这种情况下,sessionB的插入的id是不连续的,然而在lock_mode = 1的时候是会是连续的。
讨论主从复制的情况:当主库发生了这种情况,bin log面对t2表的更新只会记录这两个session的insert的语句的原始逻辑,也就是主键全部为null,而在这样的情况下,我们首先要明白,记录日志的时候实际上是按照session的整体进行记录的,要么先记录 sessionA要么就先记录sessionB,于是并发执行的情况就被抹除掉了,最终导致了从库数据和主库的数据不一致
怎么解决呢?
要解决这个问题,binlog的日志格式应该要设置为binlog_foramt = row,这样设置能够使得bin log里面记录的是主库分配的自增值,到备库执行的时候,主库的自增值是啥,从库的就会是啥
8.行锁的使用注意事项
间隙锁唯一目的是防止其他事务向间隙中插入数据。
重点:间隙锁可以共存。一个事务获取的间隙锁并不会阻止另一个事务在同一个间隙上获取间隙锁。共享间隙锁和排他间隙锁之间没有区别。它们彼此之间不冲突,执行相同的功能。允许冲突的间隙锁的原因是,如果一个记录从索引中删除,不同事务持有的该记录上的间隙锁必须被合并。
临键锁是一种将记录锁和间隙锁结合在一起的锁定方式。当在数据库中搜索或扫描索引时,临键锁会在遇到的索引记录上设置锁定,并且还会对该索引记录之前的间隙进行锁定。这样可以防止其他会话在已被锁定的索引记录之前的间隙中插入新的记录。
临键锁的作用是确保数据的一致性和避免幻读现象。
next-key lock 是前开后闭区间(a, b]
如果上X锁的row是唯一索引的话, 就不会加上Next-Key Lock, 而是会退化为Record Lock,其他情况默认上的是Next-Key Lock
插入意向锁是用于管理并发插入操作。当多个事务尝试在同一个索引间隙(两个索引记录之间的空白区域)进行插入时,插入意向锁可以确保它们不会互相冲突。
但是,临键锁和间隙锁会排斥插入意向锁。
插入意向锁仅仅是一种指示,它并不阻止其他事务对同一个间隙进行插入操作。实际上,事务B也可以在插入意向锁存在的情况下执行插入操作。然而,如果两个事务试图在同一个位置插入数据(即发生冲突),则它们必须等待对方完成操作。
意向锁的作用:在没有意向锁之前, 我们执行DDL操作时(修改表的字段或者表名之类), 需要事先判断表中是否有其他锁的存在,这个判断的过程是一行一行的扫描过去, 效率极慢。现在出现意向锁之后, 在执行DDL操作前, 可以直接判断表中是否有意向锁的存在, 而不再需要去扫描整个表的行。所以意向锁通常被设计为表锁, 而非行锁, 而且意向锁通常都是相互兼容的, 这就是设计的原因。
在使用update操作时,如果根据where条件子句的查到到的索引不存在,那么就会加上间隙锁,如果存在那么就会加上record lock只锁这一行记录。
总结:修改时添加间隙锁或record lock,插入时获取插入意向锁
另外要注意:InnoDB 中的行锁的实现依赖于索引,一旦某个加锁操作没有使用到索引,那么该锁就会退化为表锁。