1.讲一下http协议的历史各版本以及主要特点
HTTP/0.9
1991年提出了HTTP/0.9,它最主要的特点就是简单,只有一个GET命令,它虽然简单,但是充分验证了WEB服务的可行性。
HTTP/1.0
HTTP/1.0的最重要的特征就是短连接,也就是每次发送请求的时候都会建立TCP连接,等收到响应就会断开连接。因此在大量请求到来的时候,会反复的创建和销毁连接,性能就会严重下降。
HTTP/1.1
于是HTTP/1.1引入了长连接,这种机制就是说,只要请求的收发双方没有一方明确提出要断开连接,那么就会保留这条TCP连接,减少了TCP连接的三报文握手和四报文挥手的开销。
同时,由于多个请求-响应复用同一条TCP连接,这使得管道网络传输成为可能,也就是说,这时候客户端发送请求时,不必等待前一个请求的响应到达即可发送请求。
问:管道网络传输中,客户端发来的请求1,2,3,服务端返回一定要按顺序1,2,3吗?
是的,这是因为如果不按请求顺序进行响应,就有可能将A的响应给到B,将B的响应给A,造成错乱
但是HTTP/1.1还是有一部分缺点
- 报文的头部没有做压缩,而只能对
body做压缩,因此当头部的体积过大时,将导致网络I/O传输性能下降 - 将导致队头阻塞问题,虽然使用管道网络传输能够异步发送请求,但是接收响应却是同步的,在这种情况下,如果前面的响应没有发回来,然后后面的请求将一直无法接收到响应
- 没有提供解决队头阻塞的优先级机制
- 请求只能从客户端开始,服务器只能够被动响应,服务端无法主动推送服务
HTTP/2.0做了哪些优化?这个问题应该要从两个方面进行回答,第一个方面是安全方面。
HTTP/2引入了TLS1.2+,也就是基于HTTPS的机制,使得HTTP/2的传输变得更加安全了。
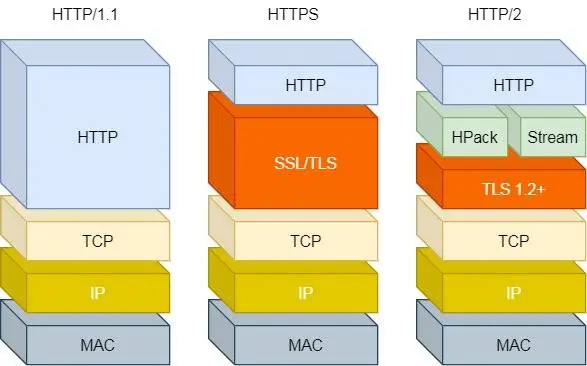
第二个是性能方面做了比较大的改动。
1.压缩首部,减少冗余传输
我们刚刚提到HTTP/1.1的报文的头部没有压缩,如果头部比较冗长,就会导致大量冗余的信息在网络中传输。
对于这个痛点,HTTP/2提供的解决方案是,客户端和服务端双方维护一张
头信息表,这张表在初始化就被静态写入一些常用的头部字段,当需要使用到这些头部字段(以key-value的形式存储)的时候,就在数据包的头部中封装一个字段header:1 xxxx,其中1代表着这个头部字段在头信息表存在,xxx代表的是索引号,当第一个字段为0的时候,代表不存在,然后后边的这些xxx就是实际上的头部字段,然后传输到对等端的时候,会将这个字段记录到动态表中,方便下次使用
2.全面二进制,节省了传输所需的数据量
HTTP/1.1的数据传输是基于文本传输的,而计算机只能读取二进制数据,因此在发送时需要将文本转换成二进制,在接收时需要将二进制转换成文本。我们采用全面二进制编码之后,比如状态码’2’ ‘0’ ‘0’ ,在http/1.1中需要占用三个字节,然而在HTTP/2中它表示为表示为1100 1000,节省了两个字节。
3.引入Stream机制,解决队头阻塞问题
我们上面提到,客户端发送了请求1,2,3后,服务端响应也要按照1,2,3的顺序来,这就会产生队头阻塞现象,
当第一个请求发送出去之后,由于I/O或者其他原因很长时间都没有收到响应,但是这时候后面的请求又都在排队,从而导致后面的请求无法得到响应,客户端陷入阻塞状态
HTTP/2.0引入了Stream流,它的核心思想就是给响应包加上一个控制字段,让这些包能够标识出来是属于谁的响应。在同一个TCP连接中存在多个Strteam,这多个Stream就代表着同一对请求-响应,他们通过标识StreamId对这些Stream进行标识,从而确保请求能够收到对应的响应。
这样的话,我们假设响应是乱序返回的,比如请求1,2发送,然后响应2,1返回,因为存在StreamId,接收方就能够通过不同Id标识拿到自己想要的数据包。本质上就是IO多路复用,提高了传输性能
4.允许服务端主动推送
主动推送是通过服务器在接收到客户端请求后,主动向客户端推送额外的资源,而不需要客户端单独请求这些资源。 例如,可以提前向客户端发送一些与请求相关的资源,以提高页面加载速度。
服务器向客户端发送一个带有 PUSH_PROMISE 帧的响应,告诉客户端将要推送的资源。 4. 客户端收到 PUSH_PROMISE 帧后,可以决定是否接受推送的资源。
HTTP/2.0的缺陷
它同样存在队头阻塞的问题,只不过它的队头阻塞问题是因为滑动窗口的限制而产生的,也就是队头阻塞产生在TCP层面,先来讲讲它是怎么产生的。
我们假设发送双方维护了一个窗口,然后A同时发送了P1/P2/P3/p4/p5然后等待ACK,然后B能够接收P1/P2
接收完P1之后,但是P2丢掉了,于是它只能够等待P2的超时重传,那么这期间,如果A再发送P3/P4/P5,都不能够再次接收。
HTTP/3.0
既然谈到了优化,那么肯定就是解决HTTP/2所没有解决的问题,HTTP/2没有解决TCP层面的队头阻塞问题
但是这个问题是致命的,因为发送窗口和接收窗口不可能无限制大小,而且为了可靠传输,必须保证数据包的有序接收,因此一个思路就是,修改底层的实现,改为
UDP实现
首先要解决的问题是:之前提供的HTTP协议都是TCP的可靠传输,那么我们必须基于UDP实现可靠传输
核心就是上图中的
QUIC协议
QUIC协议也有类似的HTTP/2中的Stream的机制,也就是说一条连接中有也有多个Stream,但是每一个Stream并不公用一个窗口,而是有各自的滑动窗口,因此如果流中的包丢失了,只会导致这个请求-响应被阻塞,其他的不被阻塞,这就解决了队头问题
与此同时,QUIC协议还基于UDP协议提高了性能
更快的连接建立
对比与HTTP/1.0、HTTP/1.1的实现,由于TCP+TLS的实现基于内核的TCP传输层和openssl库实现的,因此难以解耦,而QUIC的思路是:在完成连接握手的时候,在帧的首部携带上TLS认证信息,这个过程主要是为了确认双方的连接ID
甚至,在第二次连接的时候,应用数据包可以和 QUIC 握手信息(连接信息 + TLS 信息)一起发送,达到 0-RTT 的效果。
连接的迁移
那么当移动设备的网络从 4G 切换到 WIFI 时,意味着 IP 地址变化了,那么就必须要断开连接,然后重新建立连接。而建立连接的过程包含 TCP 三次握手和 TLS 四次握手的时延,以及 TCP 慢启动的减速过程,给用户的感觉就是网络突然卡顿了一下,因此连接的迁移成本是很高的。
而 QUIC 协议没有用四元组的方式来“绑定”连接,而是通过连接 ID 来标记通信的两个端点,客户端和服务器可以各自选择一组 ID 来标记自己,因此即使移动设备的网络变化后,导致 IP 地址变化了,只要仍保有上下文信息(比如连接 ID、TLS 密钥等),就可以“无缝”地复用原连接,消除重连的成本,没有丝毫卡顿感,达到了连接迁移的功能。
所以, QUIC 是一个在 UDP 之上的伪 TCP + TLS + HTTP/2 的多路复用的协议。
QUIC 是新协议,对于很多网络设备,根本不知道什么是 QUIC,只会当做 UDP,这样会出现新的问题,因为有的网络设备是会丢掉 UDP 包的,而 QUIC 是基于 UDP 实现的,那么如果网络设备无法识别这个是 QUIC 包,那么就会当作 UDP包,然后被丢弃。
2.讲一下进程和线程的区别?
本质区别:进程是操作系统资源分配的基本单位,线程是任务调度和执行的基本单位。
- 在开销方面:每个进程都有独立的代码和数据空间,程序之间的切换会有较大的开销;线程可以看作轻量级的进程,同一类线程共享代码和数据空间,每个线程都有自己独立的运行栈和程序计数器
- 稳定性方面:进程中每个线程如果崩溃了,可能导致整个进程崩溃。而一个进程的崩溃不会影响其他进程。
- 包含关系来看:没有线程的进程可以看作单线程的,一个线程可以有多个线程。
具体到Java里面,使用main方法的时候其实就是启动了一个JVM进程,而main函数所在的线程就是这个进程中的一个线程,也称为主线程。多个线程共享进程的堆和方法区资源,每个线程有自己的程序计数器、虚拟机栈、本地方法栈。
3.讲一下虚拟内存
虚拟内存是怎么换页的,怎么寻址的?
虚拟内存除了解决内存不够的问题,还有哪些好处?
虚拟内存有哪些坏处?
4.Java中的String,StringBuilder,StringBuffer有哪些区别?
StringBuffer是怎么保证线程安全的?
5.讲一下Java虚拟机的垃圾回收算法
CMS垃圾回收器
6.MySQL的隔离级别,各个级别有什么问题?
为什么InnoDB的默认隔离级别不是串行化?
我答串行化的并发能力很低,在一些业务下可以牺牲数据的准确性来换取性能。在他提示下我才反应过来是MVCC机制解决了RR级别下的幻读问题。
7.讲一下MVCC
mvcc我的回答中提到了undo-log