1.什么是操作系统的IO?
我们如果需要对磁盘进行读取或者写入数据的时候必须得有主体去操作,这个主体就是应用程序。 应用程序是不能直接进行一些读写操作(IO)的,因为用户可能会利用此程序直接或者间接的对计算机造成破坏,只能交给底层软件—操作系统。也就是说应用程序想要对磁盘进行读取或者写入数据,只能通过操作系统对上层开放的API来进行。在任何一个应用程序里面,都会有进程地址空间,该空间分为两部分,一部分称为用户空间(允许应用程序进行访问的空间),另一部分称为内核空间(只能给操作系统进行访问的空间,它受到保护)。
应用程序想要进行一次IO操作分为两个阶段:
- IO调用:应用程序进程向操作系统内核发起调用【1】
- IO执行:操作系统内核完成IO操作【2】
操作系统完成一次IO操作包括两个过程:
- 数据准备阶段:内核等待I/O设备准备好数据(从网卡copy到内核缓冲区)【3】
- 数据copy阶段:将数据从内核缓冲区copy到用户进程缓冲区【4】
总结来说,应用程序一次完整的I/O流程包括以下步骤:
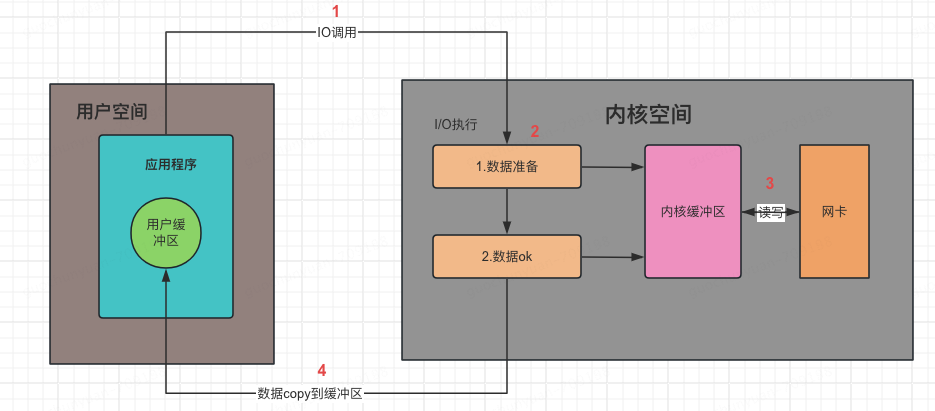
- 应用程序进程向操作系统发起IO调用请求
- 操作系统准备数据,外部设备的数据通过网卡加载到内核缓冲区
- 操作系统拷贝数据,即将内核缓冲区的数据copy到用户进程缓冲区
而一次IO的本质其实就是:等待+拷贝
2.IO模型有哪些?
2.1阻塞式IO
服务端为了处理客户端的连接和数据处理:
伪代码具体如下:
listenfd = socket();   // 打开一个网络通信套接字
bind(listenfd);        // 绑定
listen(listenfd);      // 监听
while(true) {
  buf = new buf[1024]; // 读取数据容器
  connfd = accept(listenfd);  // 阻塞 等待建立连接
  int n = read(connfd, buf);  // 阻塞 读数据
  doSomeThing(buf);  // 处理数据
  close(connfd);     // 关闭连接
}
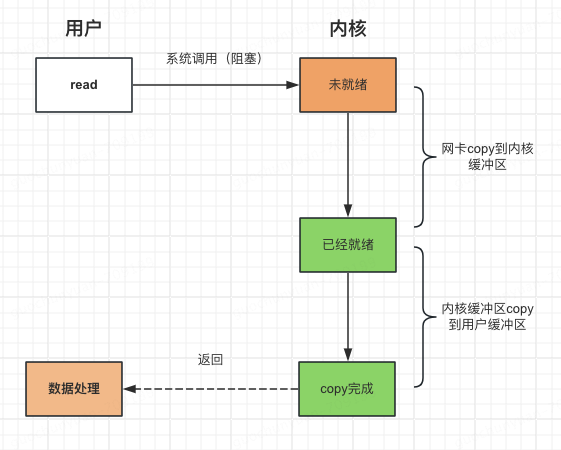
上面的伪代码中我们可以看出,服务端处理客户端的请求阻塞在两个地方,一个是 accept、一个是 read ,我们这里主要研究 read 的过程,可以分为两个阶段:等待读就绪(等待数据到达网卡 & 将网卡的数据拷贝到内核缓冲区)、读数据。
阻塞IO流程如下:
2.2非阻塞式IO
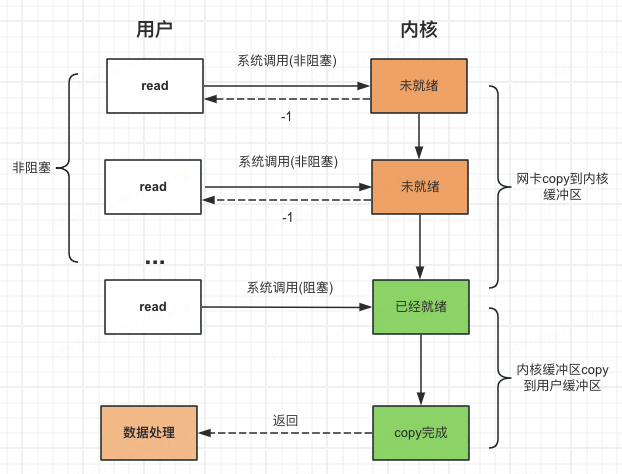
非阻塞式 IO 我们应该让操作系统提供一个非阻塞的 read() 函数,当第一阶段读未就绪时返回 -1 ,当读已就绪时才进行数据的读取。
非阻塞IO往往需要程序员循环的方式反复尝试读写文件描述符, 这个过程称为轮询(for(connfd : arr)). 这对CPU来说是较大的浪费, 一般只有特定场景下才使用。
arr = new Arr[];
listenfd = socket();   // 打开一个网络通信套接字
bind(listenfd);        // 绑定
listen(listenfd);      // 监听
while(true) {
  connfd = accept(listenfd);  // 阻塞 等待建立连接
  arr.add(connfd);
}

// 异步线程检测 连接是否可读
new Tread(){
  for(connfd : arr){
    buf = new buf[1024]; // 读取数据容器
    // 非阻塞 read 最重要的是提供了我们在一个线程内管理多个文件描述符的能力
    int n = read(connfd, buf);  // 检测 connfd 是否可读
    if(n != -1){
       newThreadDeal(buf);   // 创建新线程处理
       close(connfd);        // 关闭连接
       arr.remove(connfd);   // 移除已处理的连接
    }
  }
}

newTheadDeal(buf){
  doSomeThing(buf);  // 处理数据
}
所谓非阻塞 IO 只是将第一阶段的等待读就绪改为非阻塞,但是第二阶段的数据读取还是阻塞的,非阻塞 read 最重要的是提供了我们在一个线程内管理多个文件描述符的能力。
非阻塞具体流程如下:
3.IO多路复用
上面的实现看着很不错,但是却存在一个很大的问题,我们需要不断的调用 read() 进行系统调用,这里的系统调用我们可以理解为分布式系统的 RPC 调用,性能损耗十分严重,因为这依然是用户层的一些小把戏。
多路复用就是系统提供了一种函数可以同时监控多个文件描述符的操作,这个函数就是我们常说到的select、poll、epoll函数,可以通过它们同时监控多个文件描述符,只要有任何一个数据状态准备就绪了,就返回可读状态,这时询问线程再去通知处理数据的线程,对应线程此时再发起read()请求去读取数据。实际上最核心之处在于IO多路转接能够同时等待多个文件描述符的就绪状态,来达到不必为每个文件描述符创建一个对应的监控线程,从而减少线程资源创建的目的。
3.1select
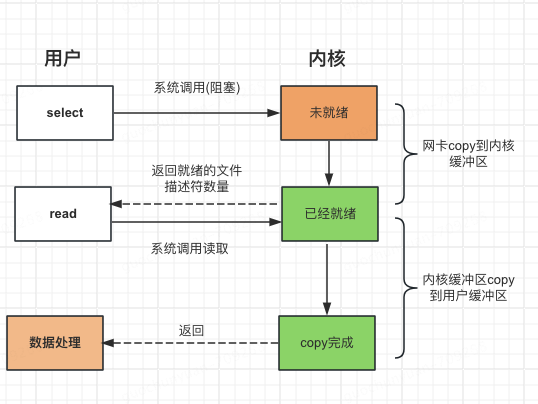
select 是操作系统提供的系统函数,通过它我们可以将文件描述符发送给系统,让系统内核帮我们遍历检测是否可读,并告诉我们进行读取数据。
流程简图:
优点:
- 减少大量系统调用
- 系统内核帮我们遍历检测是否可读
存在一些问题:
- 每次调用需要在用户态和内核态之间拷贝文件描述符数组,但高并发场景下这个拷贝的消耗是很大的
- 内核检测文件描述符是否可读还是通过遍历实现,当文件描述符数组很长时,遍历操作耗时也很长
- 内核检测完文件描述符数组后,当存在可读的文件描述符数组时,用户态需要再遍历检测一遍
3.2poll
- poll 和 select 原理基本一致,最大的区别是去掉了最大 1024 个文件描述符的限制
- select 使用固定长度的 BitsMap,表示文件描述符集合,而且所支持的文件描述符的个数是有限制的,在 Linux 系统中,由内核中的 FD_SETSIZE 限制, 默认最大值为 1024,只能监听 0~1023 的文件描述符
- poll 不再用 BitsMap 来存储所关注的文件描述符,取而代之用动态数组,以链表形式来组织,突破了 select 的文件描述符个数限制,当然还会受到系统文件描述符限制
3.3epoll
epoll 主要优化了上面三个问题实现:
- 每次调用需要在用户态和内核态之间拷贝文件描述符数组,但高并发场景下这个拷贝的消耗是很大的。
方案:内核中保存一份文件描述符,无需用户每次传入,而是仅同步修改部分。 - 内核检测文件描述符可读还是通过遍历实现,当文件描述符数组很长时,遍历操作耗时也很长。
方案:通过事件唤醒机制唤醒替代遍历 - 内核检测完文件描述符数组后,当存在可读的文件描述符数组时,用户态需要再遍历检测一遍
方案:仅将可读部分文件描述符同步给用户态,不需要用户态再次遍历
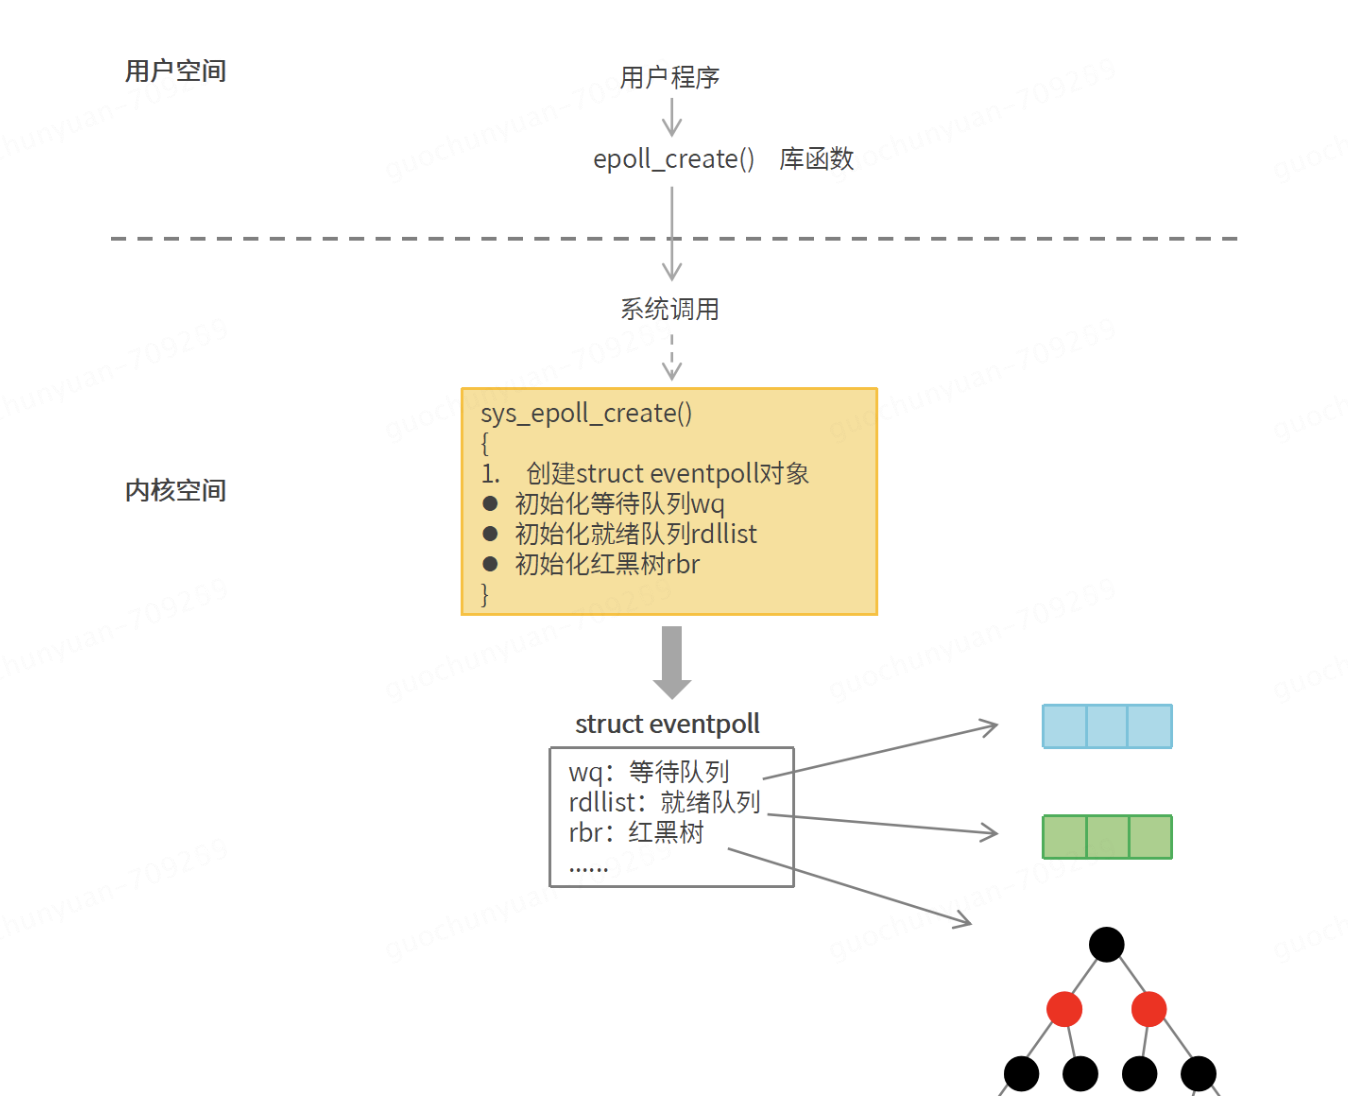
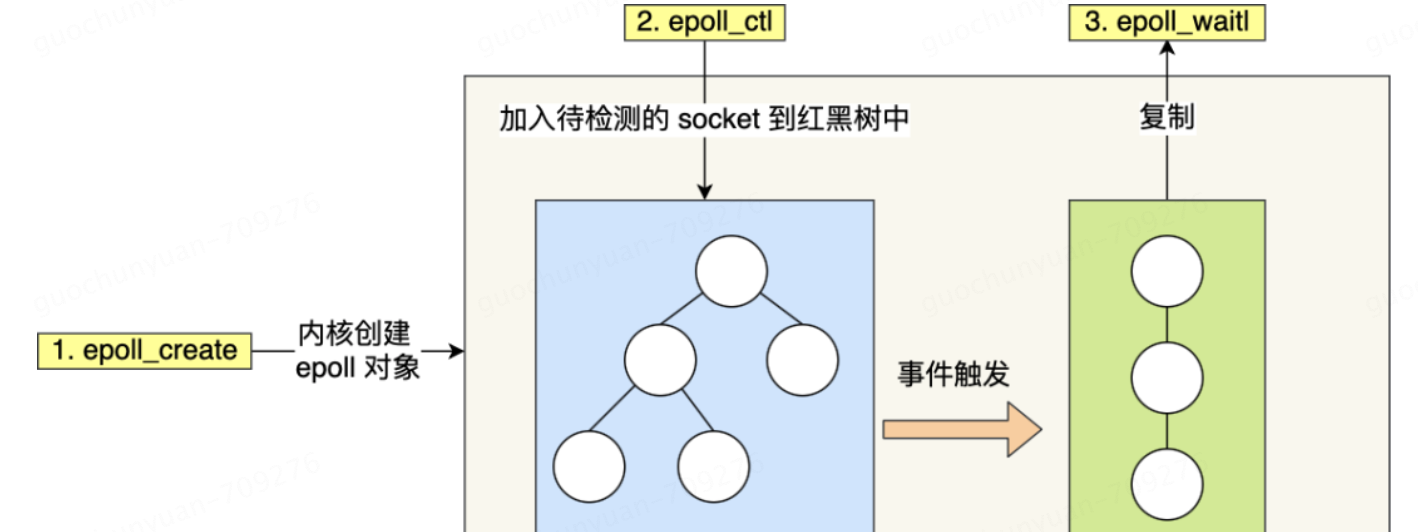
epoll 基于高效的红黑树结构,提供了三个核心操作:epoll_create、epoll_ctl、epoll_wait,也就是三步走:创建、登记、等待事件。
第一步:创建epoll对象
int epoll_fd = epoll_create();有了epoll_fd就可以管理所有的网络连接(fd)了
为什么epoll使用的数据结构是红黑树?
- 自平衡、节点有序:红黑树是一种自平衡二叉树,确保
fd列表始终保持有序,方便快速查找。 - 操作高效:红黑树的增、删、查操作的时间复杂度为
O(log N),即使面对成百上千的 (fd),也能迅速找到或更新信息。
第二步:添加fd并设定监听事件
epoll_ctl函数用于增加,删除,修改epoll事件,epoll事件会存储于内核epoll结构体红黑树中
struct epoll_event ev;
ev.events = EPOLLIN;        // 设置监听“有新请求”事件
ev.data.fd = sock_fd;       // 客户的文件描述符
epoll_ctl(epoll_fd, EPOLL_CTL_ADD, sock_fd, &ev);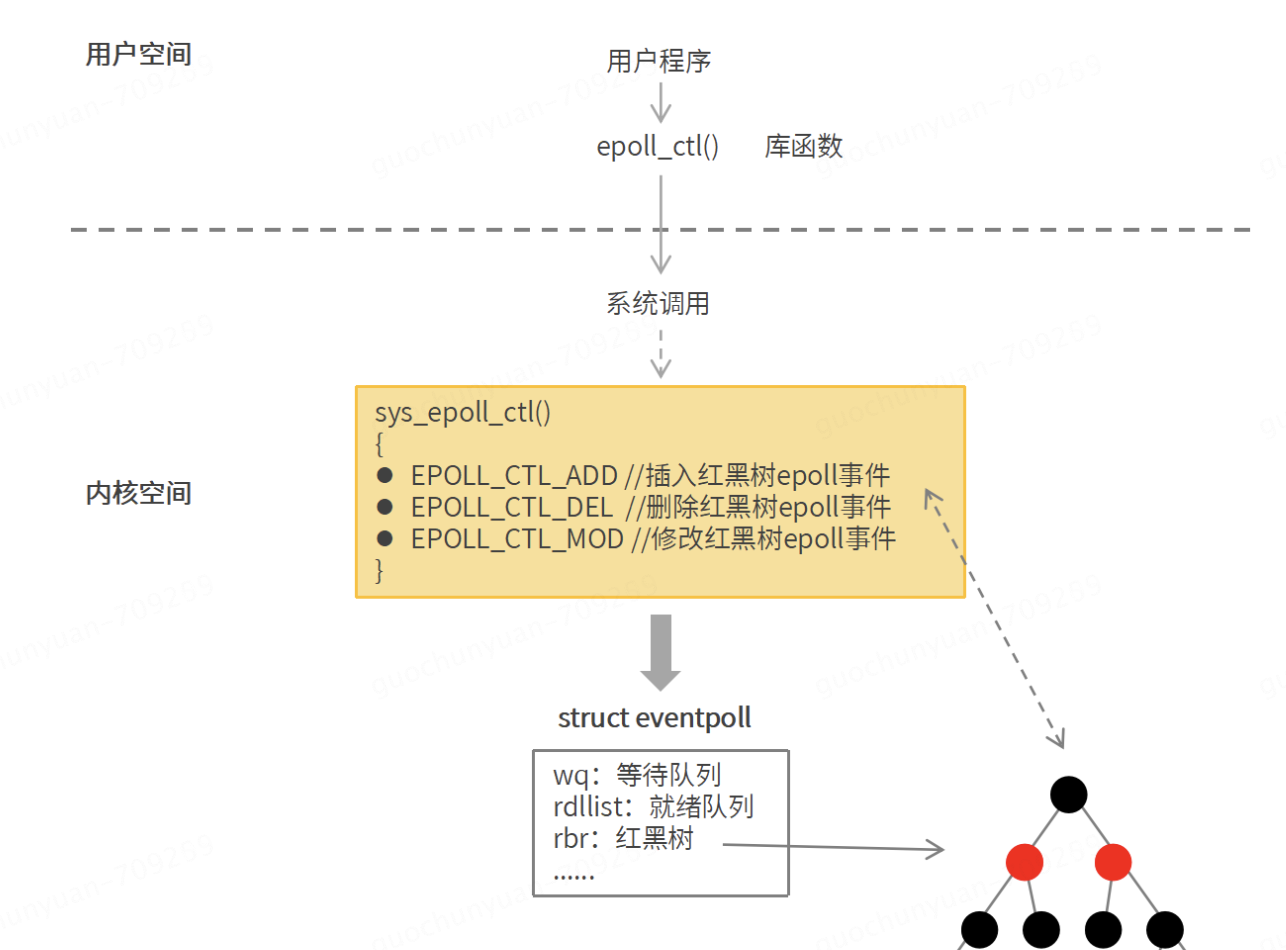
第三步:等待事件触发-集中处理fd的请求
当所有fd都登记好之后,epoll 就进入了“待命模式”,它会专注于那些“真的有事”的 VIP 客户,其他客户保持静默就不用理会。这个等待事件触发的过程通过 epoll_wait 完成,epoll_wait用于监听套接字事件。
struct epoll_event events[10];          // 用来存储触发事件的客户
int nfds = epoll_wait(epoll_fd, events, 10, -1);  // 等待事件
for (int i = 0; i < nfds; ++i) {
    if (events[i].events & EPOLLIN) {
        // 处理客户的请求
    }
}
epoll_wait 只会通知我们那些“有需求”的 VIP 客户。每当调用 epoll_wait,它会检查所有已登记的 VIP 客户,并把有事件的客户集中放在 events 数组里,返回给我们。这样一来,我们只需处理这些真正有需求的 VIP 客户,其他静默的客户则可以忽略,省时省力。
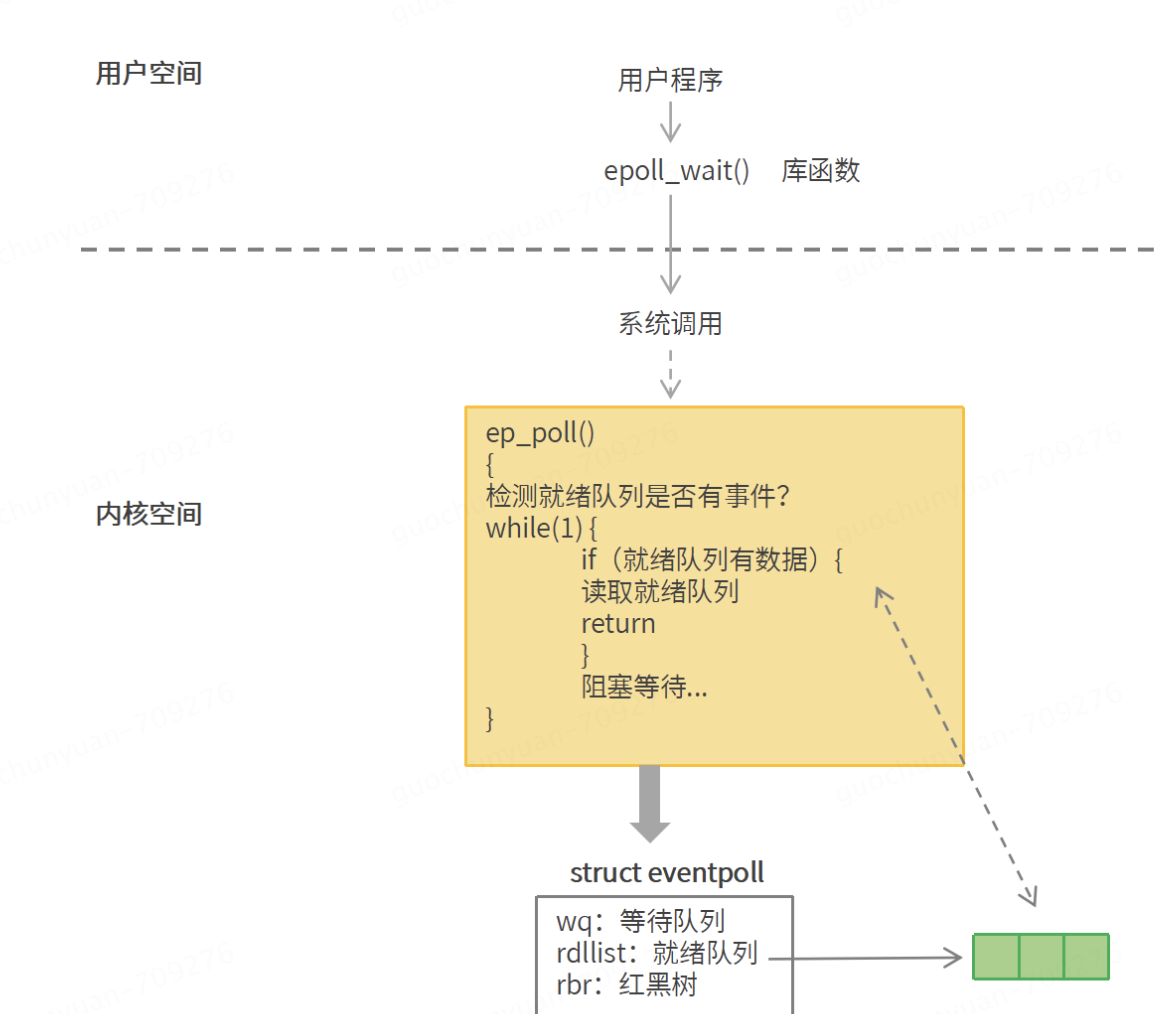
epoll 采用的另一个数据结构:双向链表:
在内核中,epoll 会把所有“发出请求”的 VIP 客户(真正有数据到来的客户端fd)从红黑树移到双向链表中。双向链表中只存储那些有数据到来的客户端 fd,这样 epoll_wait 能一次性返回所有“有数据到来”的客户端fd,进一步提高效率。
红黑树 + 双向链表:epoll 的高效组合
- 红黑树:负责管理所有 VIP 客户的注册信息,确保增删查的效率。
- 双向链表:只存放那些已触发事件的客户,保证我们只需集中处理“有需求”的客户。
这种红黑树和双向链表的组合,让 epoll 能高效筛选出有请求的 VIP 客户,把系统资源集中在真正有需求的连接上,大大提高了性能。epoll_wait 就像 epoll贴心的“智能秘书”,只提醒我们需要处理的 VIP 客户,保证我们高效完成所有请求。
整体运转如下:
伪代码如下:
listenfd = socket();   // 打开一个网络通信套接字
bind(listenfd);        // 绑定
listen(listenfd);      // 监听
int ep_fd = epoll_create(...); // 创建 epoll 对象
while(1) {
  connfd = accept(listenfd);  // 阻塞 等待建立连接
  epoll_ctl(connfd, ...);  // 将新连接加入到 epoll 对象
}

// 异步线程检测 通过 epoll_wait 阻塞获取可读的套接字
new Tread(){
  while(arr = epoll_wait()){
    for(connfd : arr){
        // 仅返回可读套接字
        newTheadDeal(connfd);
    }
  }
}

newTheadDeal(connfd){
    buf = new buf[1024]; // 读取数据容器
    int n = read(connfd, buf);  // 阻塞读取数据
    doSomeThing(buf);  // 处理数据
    close(connfd);        // 关闭连接
}
3.4为什么epoll高效?
- 红黑树:红黑树提高了epoll事件增删改查的效率
- 回调通知机制:当epoll监听套接字有数据读或者写时,会通过注册到socket的回调函数通知epoll,epoll检测到事件后,将事件存储在就绪队列(rdllist)。
- 就绪队列:epoll_wait返回成功后,会将所有就绪事件存储在事件数组,用户不需要进行无效的轮询,从而提高了效率
4.异步IO
应用只需要向内核发送一个读取请求,告诉内核它要读取数据后即刻返回;内核收到请求后会建立一个信号联系,当数据准备就绪,内核会主动把数据从内核复制到用户空间,等所有操作都完成之后,内核会发起一个通知告诉应用,我们称这种模式为异步IO模型。
异步IO的优化思路是解决应用程序需要先后发送询问请求、接收数据请求两个阶段的模式,在异步IO的模式下,只需要向内核发送一次请求就可以完成状态询问和数拷贝的所有操作。
5.同步和异步的区别
同步和异步关注的是消息通信机制.
同步:就是在发出一个调用时,自己需要参与等待结果的过程,则为同步,前面的select,poll,epoll都自己参与了,所以也称为同步IO。
异步:则指出发出调用以后,到数据准备完成,自己都未参与,则为异步IO