1.什么是索引?
- 索引是帮助mysql高效获取数据的排好序的数据结构
- 索引是存储在文件里的
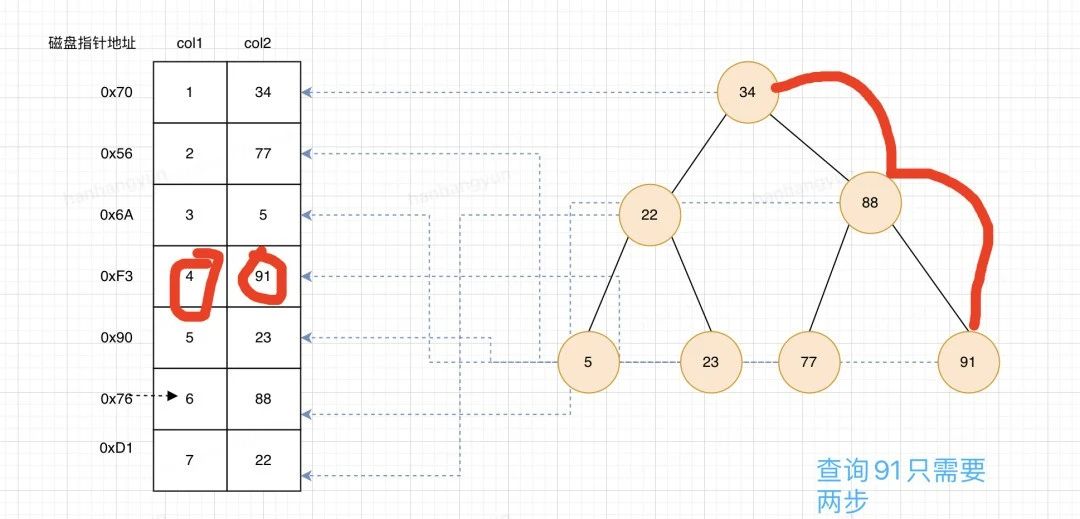
如果没有索引的话,就得循环一条一条的找,找一次就是一次IO,这样速度就会很慢。并且数据库的数据都是存在磁盘中的,我们从磁盘中取数据,每取一次就是一次IO,IO是非常耗时的。
如果没有索引,当我们查找第7条数据时,就会循环7次,如果有百万级别的数据,那么就会查找百万次,显然这样是不行的,就需要数据结构算法来优化。
2.为什么不用二叉搜索树(BST)?
二叉树节点保存的都是单个索引,高度会随着数据增大而增高,但是比一条一条的循环会快。
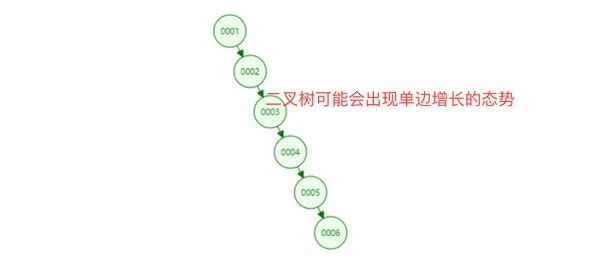
不用二叉树是因为极端情况下会出现单边增长,退化成了链表,这样在数量大的情况下,和一条一条查找没有区别。
3.为什么不用红黑树?
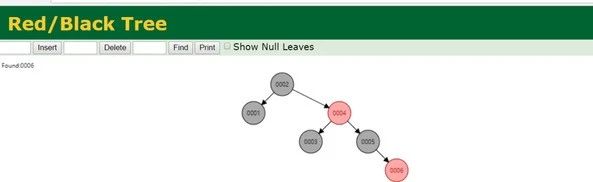
红黑树有自平衡性质,不会出现单边增长,它会动态自旋转,在性能上比二叉树又高一点,但是mysql也没有用这种数据结构,因为数据量超大的情况下,数据高度也会一直增大,在最终这个树高度也非常大,解决不了根本问题。
4.为什么不用HASH表?
哈希表是键值对的集合,通过键(key)即可快速取出对应的值(value),因此哈希表可以快速检索数据(接近 O(1))。hash算法一次就会定位到文件指针,速度快,但是还是没有用,如果范围查找的话就没有办法了。
如果只是内存中的话,他的时间复杂度是O(1),速度会会很快,但是索引文件也是保存在磁盘上,而且hash是不连续的放在磁盘上的,这样查询起来也很慢,这才是不用hash的最根本原因。
5.为什么不用B树,而是使用了B+树
相比上面的数据结构,b树增加了横向大小(度Degree),那么在高度上就减小了,查找次数就少了。
b树,也称为b-树,全称多路平衡查找树,B+ 树是 B 树的一种变体。B 树和 B+树中的 B 是 Balanced (平衡)的意思。
目前大部分数据库系统及文件系统都采用 B树或其变种 B+树作为索引结构。
B树和B+树有何异同?
- B 树的所有节点既存放键(key) 也存放数据(data),而 B+树只有叶子节点存放 key 和 data,其他内节点只存放 key。
- B 树的叶子节点都是独立的;B+树的叶子节点按照key大小顺序排列,有一条指针指相邻的叶子节点,形成了一个链表
- 在 B 树中进行范围查询时,首先找到要查找的下限,然后对 B 树进行中序遍历,直到找到查找的上限;而 B+树的范围查询,只需要对链表进行遍历即可。
mysql取一次数据一般是16K,所以节点一般设置为16K。一个节点设置成16K并且保存了索引和data的话,如果 data 数据较大时将会导致每个节点(即一个页)能存储的 key 的数量很小,当存储的数据量很大时同样会导致 B-树的深度较大,增大查询时的磁盘 I/O 次数,进而影响查询效率,所以引才使用了B+树。而且B+树在进行范围查找时效率也更高。
总结:
- B 树的所有节点既存放键(key) 也存放数据(data),而 B+树只有叶子节点存放 key 和 data,其他内节点只存放 key。如果 data 数据较大时将会导致每个节点(即一个页)能存储的 key 的数量很小,当存储的数据量很大时同样会导致 B-树的深度较大,增大查询时的磁盘 I/O 次数
- B 树的叶子节点都是独立的;B+树的叶子节点按照key大小顺序排列,有一条指针指相邻的叶子节点,形成了一个链表。在 B 树中进行范围查询时,首先找到要查找的下限,然后对 B 树进行中序遍历,直到找到查找的上限;而 B+树的范围查询,只需要对链表进行遍历即可。因此B+树在进行范围查找时效率更高。
6.MyISAM和InnoDB实现B+树的比较
在 MySQL 中,MyISAM 引擎和 InnoDB 引擎都是使用 B+Tree 作为索引结构,但是,两者的实现方式不太一样。
MyISAM 引擎中,B+Tree 叶节点的 data 域存放的是数据文件的地址,索引文件和数据文件是分离的。在索引检索的时候,首先按照 B+Tree 搜索算法搜索索引,如果指定的 Key 存在,则取出其 data 域的值,然后以 data 域的值为地址读取相应的数据记录。这被称为“非聚簇索引(非聚集索引)”。
InnoDB 引擎中,其数据文件本身就是索引文件。其表数据文件本身就是按 B+Tree 组织的一个索引结构,树的叶节点 data 域保存了完整的数据记录。这个索引的 key 是数据表的主键,因此 InnoDB 表数据文件本身就是主索引。这被称为“聚簇索引(聚集索引)”,而其余的索引都作为 辅助索引 ,辅助索引的 data 域存储相应记录主键的值而不是地址。在根据辅助索引查找时,则需要先取出主键的值,再走一遍主索引。所以建议选用数据小的主键字段做索引,字段长度越小,普通索引的叶子节点就越小,普通索引占用的空间也就越小。自增主键的插入数据模式,可以让主键索引尽量地保持递增顺序插入,不涉及到挪动其他记录,避免了页分裂,页分裂的目的就是保证后一个数据页中的所有行主键值比前一个数据页中主键值大
7.联合索引要满足最左原则
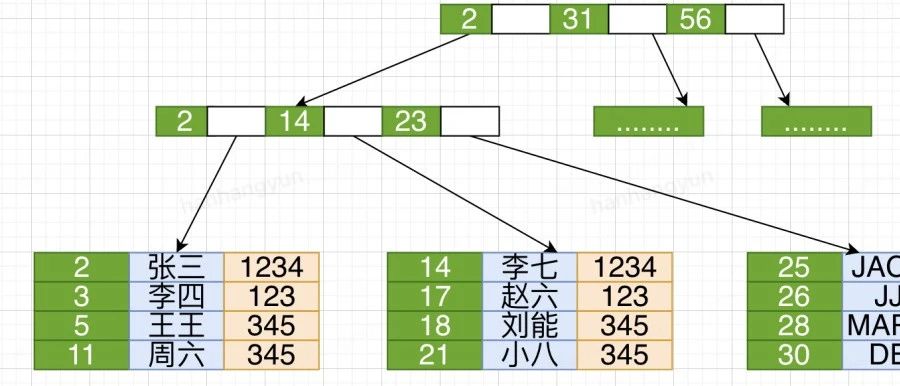
联合索引(col1, col2, col3)也是一棵B+树,其非叶子节点存储的是第一个关键字的索引,而叶子节点存储的则是三个关键字col1、col2、col3三个关键字的数据,且按照col1-col2-col3的顺序进行排序。
例如:
如果执行: SELECT * FROM T WHERE B=‘赵六’ AND C=123;
那么无法使用索引,因为索引是用A字段先排序的,如果没有先确定A,直接查找B和C,那么将会是全表查询。
如果执行: SELECT * FROM T WHERE A=‘30’ ;
那么,会先找到A字段,再在A等于30的数据中(比如有很多条),找B等于DE的数据。这样是可以用到索引的
如果执行: SELECT * FROM T WHERE A=‘18’ AND C=345;
那么,A字段可以索引,而C不能索引。所以可以部分索引,也比全表查询快
如果执行 : SELECT * FROM T WHERE B=DE AND C=1234 and A=‘2’
是用到索引的,在and的情况下如果把第一个放到最后位置也是能用到索引的
现在我想大家应该了解了什么为什么是最左原则。因为,B+树是按照最左边的字段以此构建的。