字符串
SDS
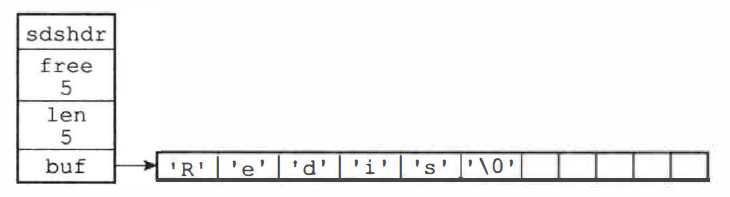
Redis 构建了简单动态字符串(SDS)的数据类型,作为 Redis 的默认字符串表示,包含字符串的键值对在底层都是由 SDS 实现
struct sdshdr {
    // 记录buf数组中已使用字节的数量,等于 SDS 所保存字符串的长度
    int len;

	// 记录buf数组中未使用字节的数量
    int free;

    // 字节数组,用于保存字符串
    char buf[];
};
SDS 遵循 C 字符串\0的惯例,保存\0的 1 字节不计算在 len 属性,SDS 会自动为\0分配额外的 1 字节空间和添加\0到字符串末尾(由SDS函数自动完成),所以\0对于 SDS 的使用者来说是完全透明的。
对比
1.常数复杂度获取字符串长度:
- C 字符串不记录自身的长度,获取时需要遍历整个字符串,遇到空字符串为止,时间复杂度为 O(N)
- SDS 在len属性记录了字符串的长度,所以获取字符串长度的复杂度为 O(1),设置和更新 SDS 长度由函数底层自动完成
2.杜绝缓冲区溢出:
C 字符串调用 strcat 函数拼接字符串时,如果字符串内存不够容纳目标字符串,就会造成缓冲区溢出(Buffer Overflow)
【例】s1 和 s2 是内存中相邻的字符串,如果一个程序员执行
strcat(s1, " Cluster")(有空格),打算将s1的内容修改为”Redis Cluster”,但粗心的他忘了在执行strcat前为s1分配足够的空间,那么在strcat函数执行后,s1的数据将溢出到s2所在的空间,导致s2保存的的内容被意外修改: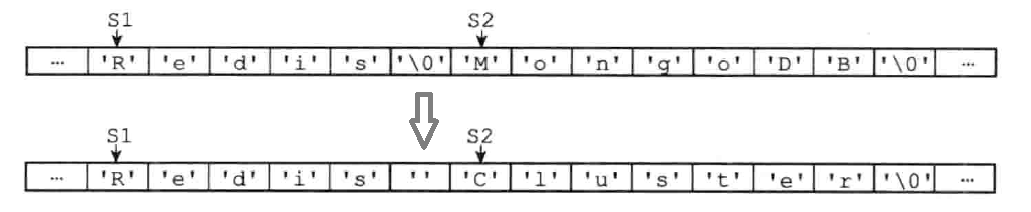
SDS 空间分配策略:当对 SDS 进行修改时,首先检查 SDS 的空间是否满足修改所需的要求, 如果不满足会自动将 SDS 的空间扩展至执行修改所需的大小,然后执行实际的修改操作, 避免了缓冲区溢出的问题
3.减少修改字符串时带来的内存重分配次数
C 字符串每次增长或者缩短都会进行一次内存重分配,拼接操作通过重分配扩展底层数组空间,截断操作通过重分配释放不使用的内存空间,防止出现内存泄露
SDS 通过未使用空间解除了字符串长度和底层数组长度之间的关联,在 SDS 中 buf 数组的长度不一定就是字符数量加一, 数组里面可以包含未使用的字节,字节的数量由 free 属性记录
内存重分配涉及复杂的算法,需要执行系统调用,是一个比较耗时的操作,SDS 的两种优化策略:
空间预分配:当 SDS 需要进行空间扩展时,程序不仅会为 SDS 分配修改所必需的空间, 还会为 SDS 分配额外的未使用空间
对 SDS 修改之后,SDS 的长度(len 属性)小于 1MB,程序分配和 len 属性同样大小的未使用空间,此时 len 和 free 相等
s 为 Redis,执行
sdscat(s, " Cluster")后,len 变为 13 字节,所以也分配了 13 字节的 free 空间,总长度变为 27 字节(额外的一字节保存空字符,13 + 13 + 1 = 27)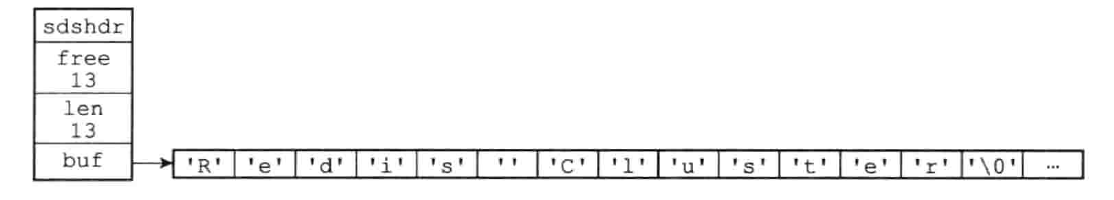
对 SDS 修改之后,SDS 的长度大于等于 1MB,程序会分配 1MB 的未使用空间
在扩展 SDS 空间前,API 会先检查 free 空间是否足够,如果足够就无需执行内存重分配,所以通过预分配策略,SDS 将连续增长 N 次字符串所需内存的重分配次数从必定 N 次降低为最多 N 次
惰性空间释放:当 SDS 缩短字符串时,程序并不立即使用内存重分配来回收缩短后多出来的字节,而是使用 free 属性将这些字节的数量记录起来,并等待将来复用
SDS 提供了相应的 API 来真正释放 SDS 的未使用空间,所以不用担心空间惰性释放策略造成的内存浪费问题
3.二进制安全:
- C 字符串中的字符必须符合某种编码(比如 ASCII)方式,除了字符串末尾以外其他位置不能包含空字符,否则会被误认为是字符串的结尾,所以只能保存文本数据
- SDS 的 API 都是二进制安全的,使用 len 属性来判断数据的结尾,所以可以保存图片、视频、压缩文件等二进制数据。这也是我们将SDS的buf属性称为字节数组的原因——Redis不是用这个数组来保存字符,而是用它来保存一系列二进制数据。
4.兼容部分 C 字符串的函数:
SDS 的API会保存的数据的末尾设置空字符串,并且总会在为 buf 数组分配空间时多分配一个字节来容纳空字符,所以可以重用一部分 C 字符串函数库的函数,从而避免了不必要的代码重复。
链表
链表提供了高效的节点重排能力,C 语言并没有内置这种数据结构,所以 Redis 构建了链表数据类型。当一个列表键包含了数量比较多的元素,又或者列表中包含的元素都是比较长的字符串,Redis就会使用链表作为列表键的底层实现
链表节点:
typedef struct listNode {
    // 前置节点
    struct listNode *prev;

    // 后置节点
    struct listNode *next;

    // 节点的值
    void *value
} listNode;
多个 listNode 通过 prev 和 next 指针组成双端链表:
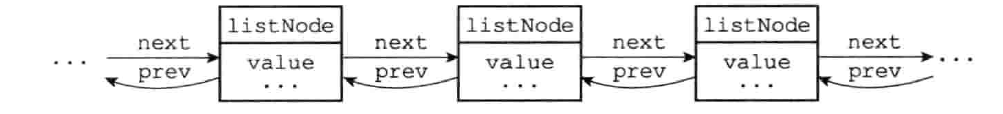
list 链表结构:提供了表头指针 head 、表尾指针 tail 以及链表长度计数器 len
typedef struct list {
    // 表头节点
    listNode *head;
    // 表尾节点
    listNode *tail;

    // 链表所包含的节点数量
    unsigned long len;

    // 节点值复制函数,用于复制链表节点所保存的值
    void *(*dup) (void *ptr);
    // 节点值释放函数,用于释放链表节点所保存的值
    void (*free) (void *ptr);
    // 节点值对比函数,用于对比链表节点所保存的值和另一个输入值是否相等
    int (*match) (void *ptr, void *key);
} list;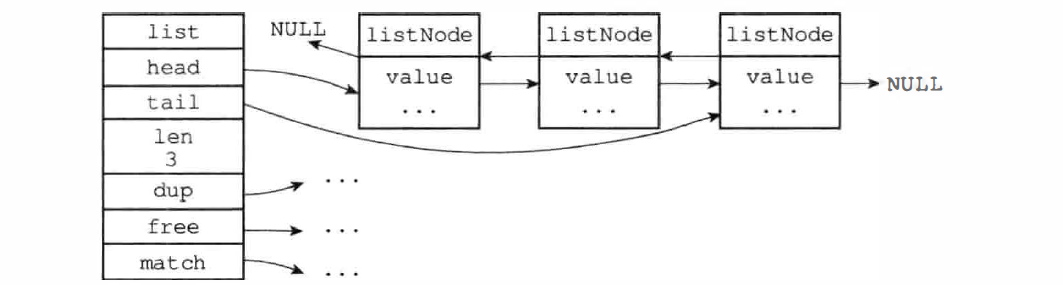
Redis 链表实现的特性可总结如下:
- 双端:链表节点带有 prev 和 next 指针,获取某个节点的前置节点和后置节点的时间复杂度都是 O(1)
- 无环:表头节点的 prev 指针和表尾节点的 next 指针都指向 NULL,对链表的访问以 NULL 为终点
- 带表头指针和表尾指针: 通过 list 结构的 head 指针和 tail 指针,获取链表的表头节点和表尾节点的时间复杂度为 O(1)
- 带链表长度计数器:使用 len 属性来对 list 持有的链表节点进行计数,获取链表中节点数量的时间复杂度为 O(1)
- 多态:链表节点使用 void * 指针来保存节点值, 并且可以通过 dup、free 、match 三个属性为节点值设置类型特定函数,所以链表可以保存各种不同类型的值
字典
字典,是一种用于保存键值对(key-value pair)的抽象数据结构。字典经常作为一种数据结构内置在很多高级编程语言里面,但Redis所使用的C语言并没有内置这种数据结构,因此Redis构建了自己的字典实现。
哈希表
Redis 的字典使用哈希表作为底层实现,一个哈希表里面可以有多个哈希表节点,而每个哈希表节点就保存了字典中的一个键值对。
结构:
typedef struct dictht {
    // 哈希表数组,数组中每个元素指向 dictEntry 结构
	dictEntry **table;

	// 哈希表大小,数组的长度
	unsigned long size;

	// 哈希表大小掩码,用于计算索引值,总是等于 【size-1】
	unsigned long sizemask;

	// 该哈希表已有节点的数量
	unsigned long used;
} dictht;
哈希表节点结构:
typedef struct dictEntry {
    // 键
	void *key;

	// 值,可以是一个指针,或者整数
	union {
        void *val;	// 指针
        uint64_t u64;
        int64_t s64;
    } v;

	// 指向下个哈希表节点,形成链表,用来解决哈希冲突(collision)问题
    struct dictEntry *next;
} dictEntry;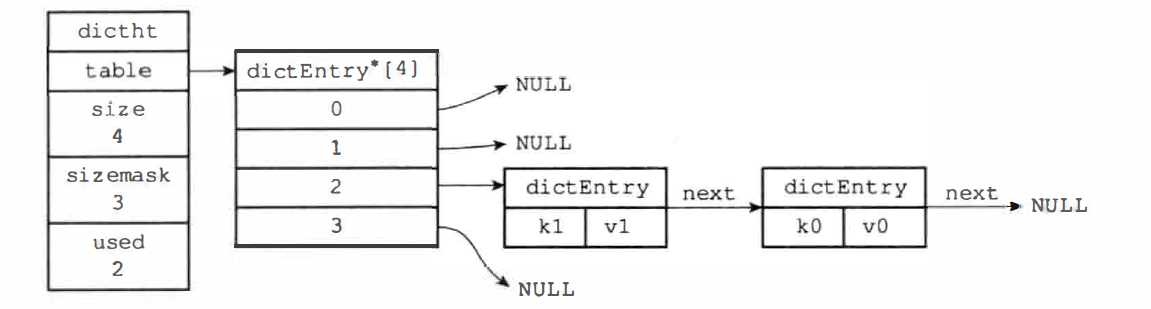
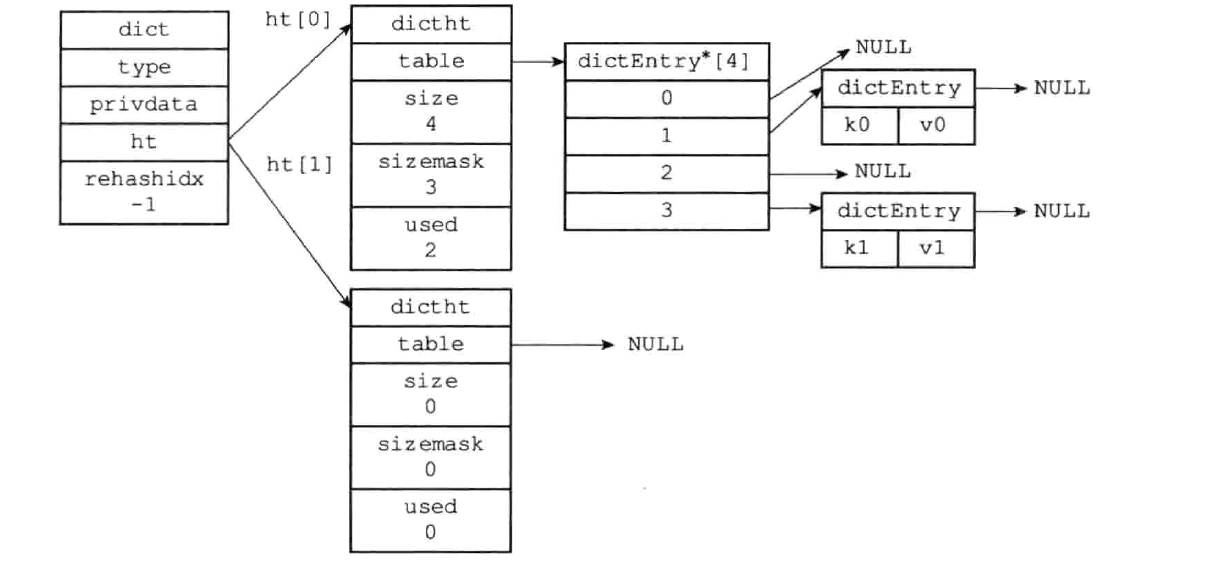
字典结构
字典,又称为符号表、关联数组、映射(Map),用于保存键值对的数据结构,字典中的每个键都是独一无二的。底层采用哈希表实现,一个哈希表包含多个哈希表节点,每个节点保存一个键值对
typedef struct dict {
    // 类型特定函数
    dictType *type;

    // 私有数据
    void *privdata;

    // 哈希表,数组中的每个项都是一个dictht哈希表,
    // 一般情况下字典只使用 ht[0] 哈希表, ht[1] 哈希表只会在对 ht[0] 哈希表进行 rehash 时使用
    dictht ht[2];

    // rehash 索引,当 rehash 不在进行时,值为 -1
    int rehashidx;
} dict;
type 属性和 privdata 属性是针对不同类型的键值对, 为创建多态字典而设置的:
- type 属性是指向 dictType 结构的指针, 每个 dictType 结构保存了一簇用于操作特定类型键值对的函数, Redis 会为用途不同的字典设置不同的类型特定函数
- privdata 属性保存了需要传给那些类型特定函数的可选参数
下面是一个普通状态下(没有进行rehash)的字典
哈希冲突
将一个新的键值对添加到字典里,需要先根据键值计算出哈希值,然后对哈希值和sizemask取模运算(取余),得到索引值:
index = hash & dict->ht[x].sizemask根据索引值,把哈希表节点放到哈希表数组的指定索引上面。
Redis 使用 MurmurHash2 算法来计算键的哈希值,这种算法的优点在于,即使输入的键是有规律的,算法仍能给出一个很好的随机分布性,并且算法的计算速度也非常快
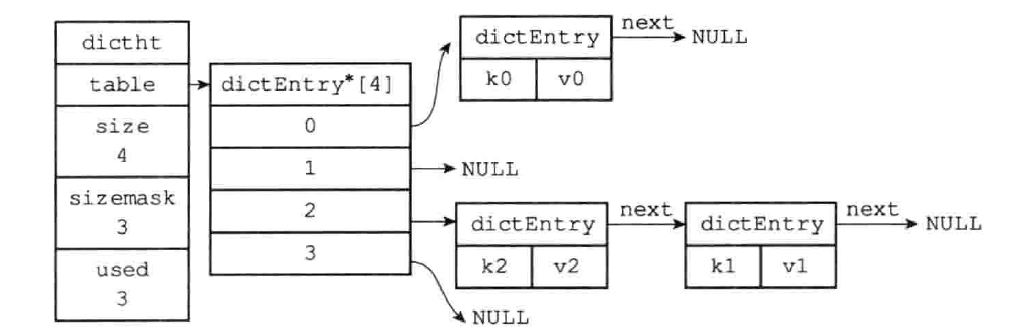
当有两个或以上数量的键被分配到了哈希表数组的同一个索引上时,就称这些键发生了哈希冲突(collision)
Redis 的哈希表使用链地址法(separate chaining)来解决键哈希冲突, 每个哈希表节点都有一个 next 指针,多个节点通过 next 指针构成一个单向链表,被分配到同一个索引上的多个节点可以用这个单向链表连接起来,这就解决了键冲突的问题
dictEntry 节点组成的链表没有指向链表表尾的指针,为了速度考虑,程序总是将新节点添加到链表的表头位置(头插法),时间复杂度为 O(1)
负载因子
负载因子的计算方式:哈希表中的节点数量 / 哈希表的大小(长度)
load_factor = ht[0].used / ht[0].size为了让哈希表的负载因子(load factor)维持在一个合理的范围之内,当哈希表保存的键值对数量太多或者太少时 ,程序会自动对哈希表的大小进行相应的扩展或者收缩
哈希表执行扩容的条件:
服务器没有执行 BGSAVE 或者 BGREWRITEAOF 命令,哈希表的负载因子大于等于 1
服务器正在执行 BGSAVE 或者 BGREWRITEAOF 命令,哈希表的负载因子大于等于 5
原因:执行这两个命令的过程中,Redis 需要创建当前服务器进程的子进程,而大多数操作系统都采用写时复制(copy-on-write)技术来优化子进程的使用效率,通过提高执行扩展操作的负载因子,尽可能地避免在子进程存在期间进行哈希表扩展操作,可以避免不必要的内存写入操作,最大限度地节约内存
哈希表执行收缩的条件:负载因子小于 0.1(自动执行,servreCron 中检测)
重新散列
扩展和收缩哈希表的操作通过 rehash(重新散列)来完成,步骤如下:
- 为字典的 ht[1] 哈希表分配空间,空间大小取决于要执行的操作:
- 如果执行的是扩展操作,ht[1] 的大小为第一个大于等于 ht[0].used * 2 的 2^n
- 如果执行的是收缩操作,ht[1] 的大小为第一个大于等于 ht[0].used 的 2^n
- 将保存在 ht[0] 中所有的键值对重新计算哈希值和索引值,迁移到 ht[1] 上
- 当 ht[0] 包含的所有键值对都迁移到了 ht[1] 之后(ht[0] 变为空表),释放 ht[0],将 ht[1] 设置为 ht[0],并在 ht[1] 创建一个新的空白哈希表,为下一次 rehash 做准备
如果哈希表里保存的键值对数量很少,rehash 就可以在瞬间完成,但是如果哈希表里数据很多,那么要一次性将这些键值对全部 rehash 到 ht[1] 需要大量计算,可能会导致服务器在一段时间内停止服务
因此,为了避免rehash对服务器性能造成影响,Redis 对 rehash 做了优化,使 rehash 的动作并不是一次性、集中式的完成,而是分多次,渐进式的完成,又叫渐进式 rehash
以下是渐进式rehash的详细步骤:
- 为 ht[1] 分配空间,此时字典同时持有 ht[0] 和 ht[1] 两个哈希表
- 在字典中维护了一个索引计数器变量 rehashidx,并将变量的值设为 0,表示 rehash 正式开始
- 在 rehash 进行期间,每次对字典执行增删改查操作时,程序除了执行指定的操作以外,还会顺带将 ht[0] 哈希表在 rehashidx 索引上的所有键值对 rehash 到 ht[1],rehash 完成之后将 rehashidx 属性的值增一
- 随着字典操作的不断执行,最终在某个时间点 ht[0] 的所有键值对都被 rehash 至 ht[1],将 rehashidx 属性的值设为 -1
渐进式 rehash 采用分而治之的方式,将 rehash 键值对所需的计算工作均摊到对字典的每个添加、删除、查找和更新操作上,从而避免了集中式 rehash 带来的庞大计算量
渐进式 rehash 期间的哈希表操作:
- 字典的查找、删除、更新操作会在两个哈希表上进行,比如查找一个键会先在 ht[0] 上查找,查找不到就去 ht[1] 继续查找
- 字典的添加操作会直接在 ht[1] 上添加,不在 ht[0] 上进行任何添加
跳跃表
底层结构
跳跃表(skiplist)是一种有序(默认升序)的数据结构,在链表的基础上增加了多级索引以提升查找的效率,索引是占内存的,所以是一个空间换时间的方案,跳表平均 O(logN)、最坏 O(N) 复杂度的节点查找,效率与平衡树相当但是实现更简单
Redis 只在两个地方应用了跳跃表,一个是实现有序集合键,另一个是在集群节点中用作内部数据结构。如果一个有序集合包含的元素数量比较多,又或者有序集合中的元素是比较长的字符串时,Redis就会使用跳跃表来作为有序集合键的底层实现。
Redis的跳跃表由zskiplistNode和zskiplist两个结构定义,其中zskiplistNode结构用于表示跳跃表节点,而zskiplist结构用于保存跳跃表节点的相关信息,比如节点的数量,以及指向表头节点和表尾节点的指针等等。
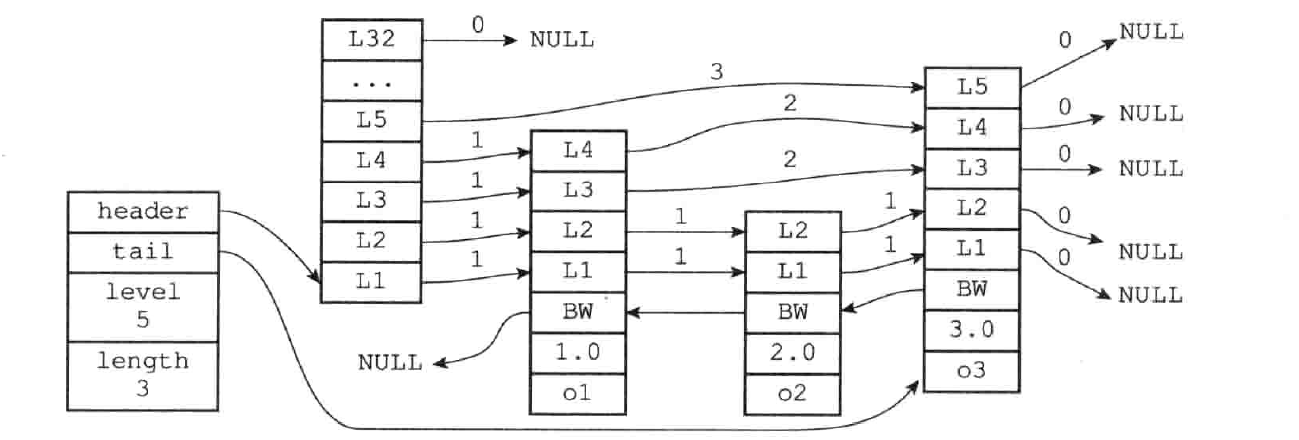
typedef struct zskiplist {
    // 表头节点和表尾节点,O(1) 的时间复杂度定位头尾节点
    struct skiplistNode *head, *tail;

    // 表的长度,也就是表内的节点数量 (表头节点不计算在内)
    unsigned long length;

    // 表中层数最大的节点的层数 (表头节点的层高不计算在内)
    int level
} zskiplist;
typedef struct zskiplistNode {
// 层
struct zskiplistLevel {
// 前进指针
struct zskiplistNode *forward;
// 跨度
unsigned int span;
} level[];
// 后退指针
struct zskiplistNode *backward;
// 分值
double score;
// 成员对象
robj *obj;
} zskiplistNode;层:跳跃表节点的level数组可以包含多个元素,每个元素都包含一个指向其他节点的指针,程序可以通过这些层加快访问其他节点的速度,一般来说,层数越多,访问其他节点的速度越快。
跨度:层的跨度(level[i].span属性)用于记录两个节点之间的距离;初看上去,很容易以为跨度和遍历操作有关,但实际上并不是这样,遍历操作只使用前进指针就可以完成,跨度实际上是用来计算排位(rank)的:在查找某个节点的过程中,将沿途访问过的所有层累计起来,得到的结果就是目标节点在跳跃表中的排位。
分值和成员:节点的分值(score属性)是一个double类型的浮点数,跳跃表中的所有节点都按分值从小到大来排序,当分值相同时,节点按照成员对象的大小进行排序。节点的成员对象(obj属性)是一个指针,它指向一个字符串对象。
属性分析
层:level 数组包含多个元素,每个元素包含指向其他节点的指针。根据幕次定律(power law,越大的数出现的概率越小)随机生成一个介于 1 和 32 之间的值(Redis5 之后最大为 64)作为 level 数组的大小,这个大小就是层的高度,节点的第一层是 level[0] = L1
前进指针:forward 用于从表头到表尾方向正序(升序)遍历节点,遇到 NULL 停止遍历
跨度:level[i].span 用于记录两个节点之间的距离,用来计算排位(rank):
两个节点之间的跨度越大相距的就越远,指向 NULL 的所有前进指针的跨度都为 0
在查找某个节点的过程中,将沿途访问过的所有层的跨度累计起来,结果就是目标节点在跳跃表中的排位
后退指针:backward 用于从表尾到表头方向逆序(降序)遍历节点
分值:score 属性,一个 double 类型的浮点数,跳跃表中的所有节点都按分值从小到大来排序
成员对象:obj 属性是一个指针,指向一个 SDS 字符串对象。同一个跳跃表中,各个节点保存的成员对象必须是唯一的,但是多个节点保存的分值可以是相同的,分值相同的节点将按照成员对象在字典序中的大小来进行排序(从小到大)
个人笔记:JUC → 并发包 → ConcurrentSkipListMap 详解跳跃表
整数集合
底层结构
整数集合(intset)是用于保存整数值的集合数据结构,是 Redis 集合键的底层实现之一。当一个集合集合只包含整数值元素,并且这个集合的元素数量不多时,Redis就会使用整数集合作为集合键的底层实现。
typedef struct intset {
	// 编码方式
	uint32_t encoding;

	// 集合包含的元素数量,也就是 contents 数组的长度
	uint32_t length;

	// 保存元素的数组
    int8_t contents[];
} intset;
encoding 取值为三种:INTSET_ENC_INT16、INTSET_ENC_INT32、INTSET_ENC_INT64
整数集合的每个元素都是 contents 数组的一个数组项(item),在数组中按值的大小从小到大有序排列,并且数组中不包含任何重复项。虽然 contents 属性声明为 int8_t 类型,但实际上数组并不保存任何 int8_t 类型的值, 真正类型取决于 encoding 属性
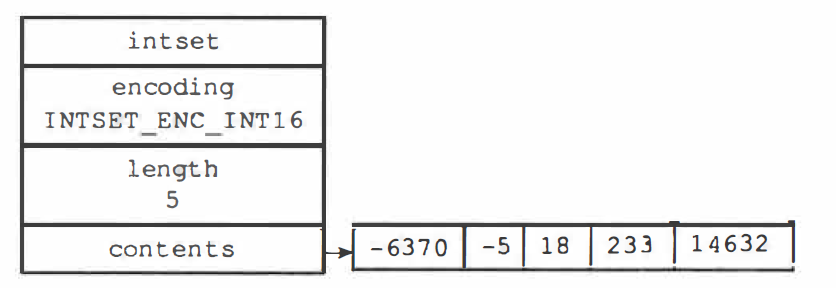
说明:底层存储结构是数组,所以为了保证有序性和不重复性,每次添加一个元素的时间复杂度是 O(N)
类型升级
整数集合添加的新元素的类型比集合现有所有元素的类型都要长时,需要先进行升级(upgrade),升级流程:
根据新元素的类型长度以及集合元素的数量(包括新元素在内),扩展整数集合底层数组的空间大小
将底层数组现有的所有元素都转换成与新元素相同的类型,并将转换后的元素放入正确的位置,放置过程保证数组的有序性
图示 32 * 4 = 128 位,首先将 3 放入索引 2(64 位 - 95 位),然后将 2 放置索引 1,将 1 放置在索引 0,从后向前依次放置在对应的区间,最后放置 65535 元素到索引 3(96 位- 127 位),修改 length 属性为 4
将新元素添加到底层数组里
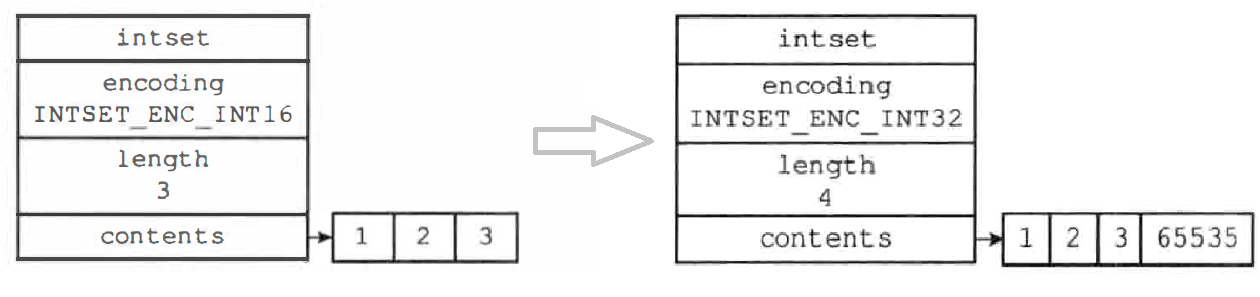
每次向整数集合添加新元素都可能会引起升级,而每次升级都需要对底层数组中的所有元素进行类型转换,所以向整数集合添加新元素的时间复杂度为 O(N)
引发升级的新元素的长度总是比整数集合现有所有元素的长度都大,所以这个新元素的值要么就大于所有现有元素,要么就小于所有现有元素,升级之后新元素的摆放位置:
- 在新元素小于所有现有元素的情况下,新元素会被放置在底层数组的最开头(索引 0)
- 在新元素大于所有现有元素的情况下,新元素会被放置在底层数组的最末尾(索引 length-1)
整数集合升级策略的好处:
提升整数集合的灵活性:C 语言是静态类型语言,为了避免类型错误通常不会将两种不同类型的值放在同一个数据结构里面,整数集合可以自动升级底层数组来适应新元素,所以可以随意的添加整数
节约内存:要让数组可以同时保存 int16、int32、int64 三种类型的值,可以直接使用 int64_t 类型的数组作为整数集合的底层实现,但是会造成内存浪费,整数集合可以确保升级操作只会在有需要的时候进行,尽量节省内存
整数集合不支持降级操作,一旦对数组进行了升级,编码就会一直保持升级后的状态
压缩列表
底层结构
压缩列表(ziplist)是 Redis 为了节约内存而开发的,是列表键和哈希键的底层实现之一。是由一系列特殊编码的连续内存块组成的顺序型(sequential)数据结构,一个压缩列表可以包含任意多个节点(entry),每个节点可以保存一个字节数组或者一个整数值

- zlbytes:uint32_t 类型 4 字节,记录整个压缩列表占用的内存字节数,在对压缩列表进行内存重分配或者计算 zlend 的位置时使用
- zltail:uint32_t 类型 4 字节,记录压缩列表表尾节点距离起始地址有多少字节,通过这个偏移量程序无须遍历整个压缩列表就可以确定表尾节点的地址
- zllen:uint16_t 类型 2 字节,记录了压缩列表包含的节点数量,当该属性的值小于 UINT16_MAX (65535) 时,该值就是压缩列表中节点的数量;当这个值等于 UINT16_MAX 时节点的真实数量需要遍历整个压缩列表才能计算得出
- entryX:列表节点,压缩列表中的各个节点,节点的长度由节点保存的内容决定
- zlend:uint8_t 类型 1 字节,是一个特殊值 0xFF (255),用于标记压缩列表的末端
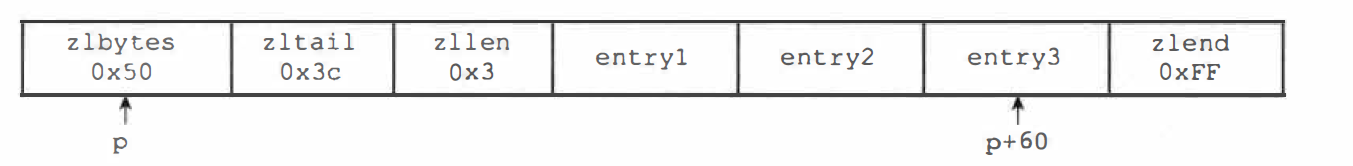
列表 zlbytes 属性的值为 0x50 (十进制 80),表示压缩列表的总长为 80 字节,列表 zltail 属性的值为 0x3c (十进制 60),假设表的起始地址为 p,计算得出表尾节点 entry3 的地址 p + 60
列表节点
列表节点 entry 的数据结构:
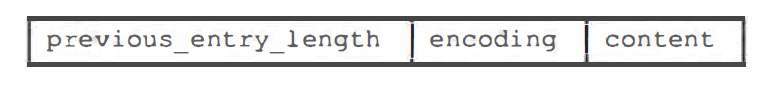
previous_entry_length:以字节为单位记录了压缩列表中前一个节点的长度,程序可以通过指针运算,根据当前节点的起始地址来计算出前一个节点的起始地址,完成从表尾向表头遍历操作
- 如果前一节点的长度小于 254 字节,该属性的长度为 1 字节,前一节点的长度就保存在这一个字节里
- 如果前一节点的长度大于等于 254 字节,该属性的长度为 5 字节,其中第一字节会被设置为 0xFE(十进制 254),之后的四个字节则用于保存前一节点的长度
encoding:记录了节点的 content 属性所保存的数据类型和长度
长度为 1 字节、2 字节或者 5 字节,值的最高位为 00、01 或者 10 的是字节数组编码,数组的长度由编码除去最高两位之后的其他位记录,下划线
_表示留空,而b、x等变量则代表实际的二进制数据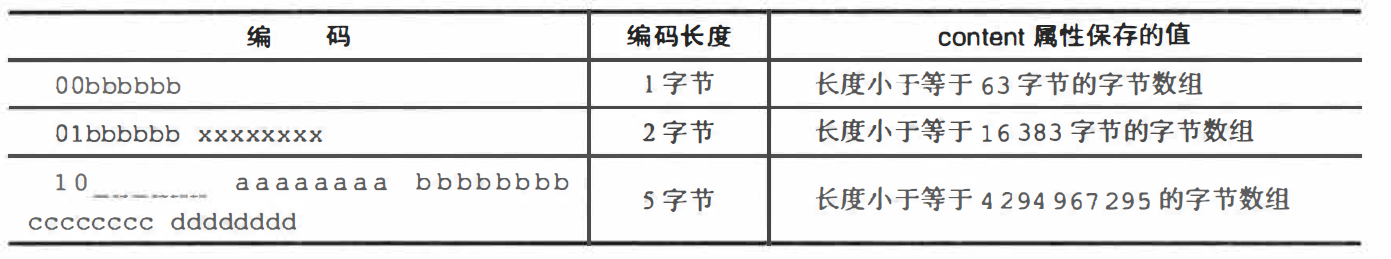
长度为 1 字节,值的最高位为 11 的是整数编码,整数值的类型和长度由编码除去最高两位之后的其他位记录
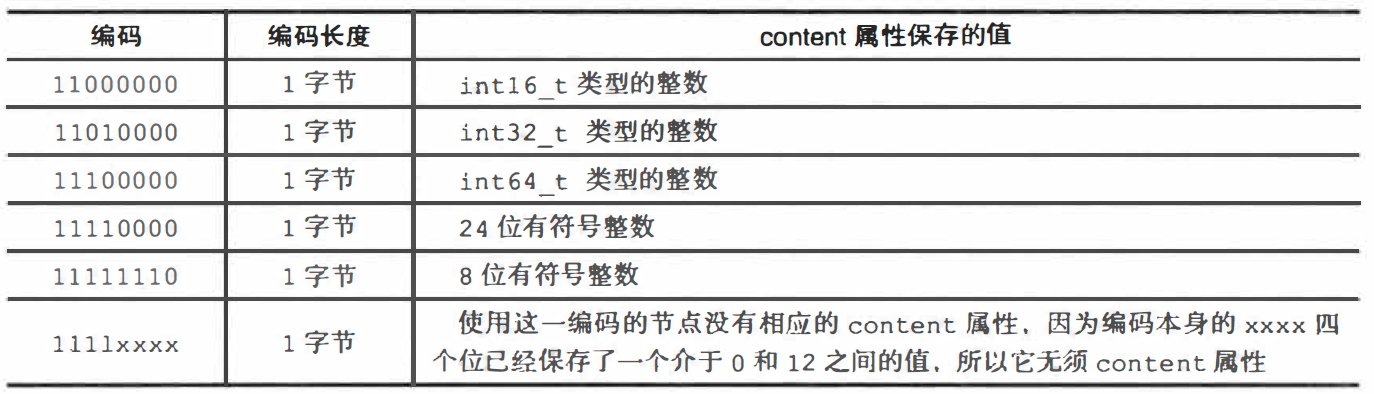
content:每个压缩列表节点可以保存一个字节数组或者一个整数值
字节数组可以是以下三种长度的其中一种:
长度小于等于 $63 (2^6-1)$ 字节的字节数组
长度小于等于 $16383(2^{14}-1)$ 字节的字节数组
长度小于等于 $4294967295(2^{32}-1)$ 字节的字节数组
整数值则可以是以下六种长度的其中一种:
4 位长,介于 0 至 12 之间的无符号整数
1 字节长的有符号整数
3 字节长的有符号整数
int16_t 类型整数
int32_t 类型整数
int64_t 类型整数
连锁更新
Redis 将在特殊情况下产生的连续多次空间扩展操作称之为连锁更新(cascade update)
假设在一个压缩列表中,有多个连续的、长度介于 250 到 253 字节之间的节点 e1 至 eN。将一个长度大于等于 254 字节的新节点 new 设置为压缩列表的头节点,new 就成为 e1 的前置节点。e1 的 previous_entry_length 属性仅为 1 字节,无法保存新节点 new 的长度,所以要对压缩列表执行空间重分配操作,并将 e1 节点的 previous_entry_length 属性从 1 字节长扩展为 5 字节长。由于 e1 原本的长度介于 250 至 253 字节之间,所以扩展后 e1 的长度就变成了 254 至 257 字节之间,导致 e2 的 previous_entry_length 属性无法保存 e1 的长度,程序需要不断地对压缩列表执行空间重分配操作,直到 eN 为止
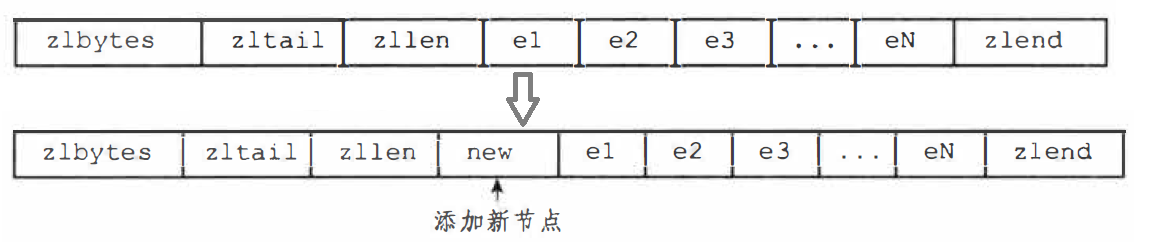
删除节点也可能会引发连锁更新,big.length >= 254,small.length < 254,删除 small 节点
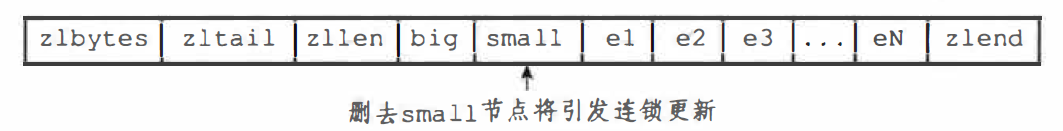
连锁更新在最坏情况下需要对压缩列表执行 N 次空间重分配,每次重分配的最坏复杂度为 O(N),所以连锁更新的最坏复杂度为 O(N^2)
说明:尽管连锁更新的复杂度较高,但出现的记录是非常低的,即使出现只要被更新的节点数量不多,就不会对性能造成影响